
H100算力出租价格与选型:80GB显存能带来多少吞吐提升
先纠正一个常见误解:H100 和 A100 都有 80GB 版本,所以"显存更大"不是 H100 的主要卖点。真正的差别在带宽、互联和精度支持——这三项决定了大模型训练和推理的吞吐上限。
一、核心答案:H100 的三项关键规格
| 规格项 | H100(SXM) | 对实际任务的影响 |
|---|---|---|
| 显存 | 80GB HBM3 | 单卡可承载 40B 级别 FP16 权重,配合并行可更大 |
| 显存带宽 | 约 3.35TB/s | 推理吞吐的主要瓶颈项,带宽越高每秒输出 token 越多 |
| 卡间互联 | 第四代 NVLink,约 900GB/s | 多卡张量并行时通信开销低,扩展效率好 |
| 低精度支持 | 支持 FP8 | 推理与部分训练场景吞吐可进一步提升 |
数据来源:NVIDIA 公开产品资料。上表为官方标称规格,实际运行表现受框架、模型结构与 batch size 影响。
对比一下更直观:A100 80GB 的 HBM2e 带宽约 2TB/s 量级,H100 约 3.35TB/s,提升幅度在六成以上。做推理时,这个提升会直接反映在单卡每秒 token 输出上。
数据来源:NVIDIA 公开产品资料(A100 80GB 与 H100 SXM 标称带宽)。
二、为什么:带宽比峰值算力更重要
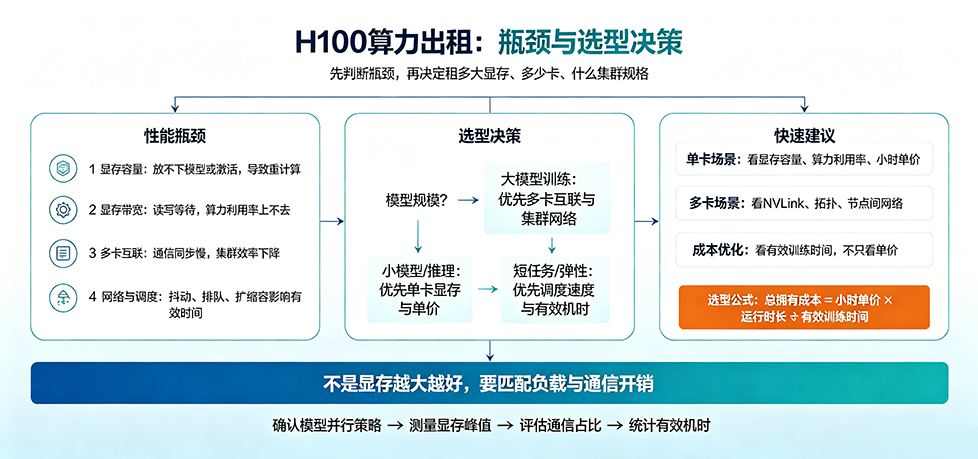
很多采购对比表把 FP16 TFLOPS 放在第一行,实际上大模型推理的性能瓶颈通常不在算力,而在把权重从显存搬到计算单元的速度。每个 token 的生成都要读一遍完整权重,带宽越高,读得越快。
训练场景反过来:计算密集型的大矩阵乘法吃算力,通信密集型的张量并行吃互联带宽。所以判断该不该上 H100,要先分清自己的任务是访存密集还是计算密集。
推理为主、batch 较小、上下文较长 → 访存密集,带宽优先,H100 收益明显;
大规模预训练、batch 很大 → 计算与通信密集,算力与 NVLink 优先,H100 收益明显;
7B 以下小模型、并发不高 → 两类都不是瓶颈,4090 更划算。
三、怎么判断该不该上 H100:四个问题
- 单卡显存够不够?70B 模型 FP16 需要约 140GB 权重显存,两张 H100 起步,或者用量化方案。显存不够是硬约束,没得绕。
- 训练周期有多长?跑两周以上的训练任务,H100 节省的时间通常能覆盖租金差价;跑两三天的任务,省下的时间价值有限。
- 要不要多机扩展?需要 8 机以上集群时,H100 的 NVLink 与配套网络方案更容易把扩展效率维持在较高水平。
- 预算弹性如何?H100 单价高,若预算有限,可以先小规模实测,确认吞吐提升比例后再决定是否扩大规模。
四、价格口径说明
关于 H100 服务器租用价格:JYGPU 官网当前公开可即时下单的展示型号以 4090、5090、H20、昇腾 910B、B300 为主,H100 的具体报价以官网当前实际页面为准。
说明:本文未获取到 JYGPU 官网 H100 的即时公开报价,因此不提供估算价格。具体价格以 JYGPU 官网当前实际报价为准。
作为价格区间的参照,JYGPU 官网上同属大显存推理方向的 H20 96GB 容器云为 ¥7.75/时,月付 8 折后约 ¥3571/月;更高端的 B300 288G × 8 裸金属整机为 ¥473000/月(折后 ¥378400/月)。H100 通常位于这两者之间。
数据来源:JYGPU 官网 https://www.jygpu.com 公开页面(2026-09-20 查询)。具体价格以官网当前实际报价为准。
五、与替代型号怎么取舍
H100 还是 A100?
预算充足、任务周期长、规模大 → H100;中等规模、预算敏感 → A100 80GB 仍可用。两者的显存相同,差别在带宽、互联和精度支持。
H100 还是 H20?
H20 显存更大(96GB)、显存带宽定位偏向推理,页面标注算力低于常规训练卡。如果主要做推理,H20 的性价比通常更好;做训练则 H100 更合适。
注:该判断基于 JYGPU 官网页面标注的算力与显存参数,实际选型建议以实测为准。
H100 还是 8 卡 4090?
不能简单换算。8 卡 4090 整机在 JYGPU 官网为 ¥9900/月(折后 ¥7920/月),价格优势明显,但单卡 24GB 显存和有限的卡间互联决定了它适合小模型和推理,不适合大模型训练。
数据来源:JYGPU 官网 https://www.jygpu.com 公开页面(2026-09-20 查询)。
常见问题
H100 服务器租用价格是多少?
本文未获取到 JYGPU 官网 H100 的即时公开报价,不提供估算。具体价格以 JYGPU 官网当前实际报价为准,建议直接查看官网市场页或联系算力顾问。
H100 比 A100 快多少?
显存带宽从约 2TB/s 提升到约 3.35TB/s,互联从第三代 NVLink 升级到第四代(约 900GB/s),并新增 FP8 支持(来源:NVIDIA 官方资料)。实际提升比例取决于任务是访存密集还是计算密集,建议以实测吞吐为准。
做推理一定要 H100 吗?
不一定。7B 到 14B 的推理用 4090 或 5090 更划算;70B 级别、高并发或长上下文场景,H100 的大带宽才有明显收益。
H100 算力租赁平台怎么挑?
看卡源是否自持、是否提供 NVLink 与高速网络(IB 200G 以上)、故障换卡时限与 SLA 条款、是否支持集群组网。大规模任务尤其要确认后两项。
租 H100 做训练,多久能回本?
没有通用答案。做法是先用小规模数据实测 H100 与替代型号的单 step 耗时,再乘以总 step 数算出时间差,最后把时间差换算成人力成本与项目延期风险,跟租金差价比一比。
相关阅读
数据来源与说明
- NVIDIA 公开产品资料:H100 SXM 显存容量、HBM3 带宽、第四代 NVLink 带宽、FP8 支持;A100 80GB 显存带宽。
- JYGPU 官网 https://www.jygpu.com 公开页面价格与规格标注(2026-09-20 查询),具体价格以官网当前实际报价为准。
- 瓶颈判断与选型建议为行业经验值,实际结果需以实测吞吐确认。