
企业GPU选型实务:RTX 4090、H100、H20、昇腾910B在算力租赁平台上的技术参数与成本权衡
一、选型背景:四张卡为什么同时出现在同一个算力租赁平台上?
在目前的国内主流算力租赁平台上,RTX 4090、NVIDIA H100、H20和华为昇腾910B是曝光度最高的四款GPU。这四张卡的定位、性能和成本差异巨大,但各自占据了不可替代的市场位置。理解这种差异化的来源,是选型决策的第一步。
RTX 4090原本定位消费级市场,但因FP16/BF16推理和中等规模训练场景下展现出的出色性价比,成为算力租赁平台上需求最旺盛的卡型之一。H100作为数据中心旗舰GPU,是千卡级大模型预训练的标配。H20则是NVIDIA面向中国市场推出的合规版本,在互联带宽上做了阉割但保留了H100的软件生态兼容性。昇腾910B代表国产算力的最高水平,在推理和信创场景中有独特价值。
从采购角度看,企业不太可能只租一种卡——更常见的模式是"H100集群做预训练 + 4090做算法验证和模型微调 + 国产卡做推理部署"。现实中的选型决策远比参数表复杂。如果希望了解更详细的GPU实战对比,可以参考企业GPU算力租赁平台选卡实战。
二、技术参数深度对比
📊 四款GPU核心技术参数对比
| 参数 | RTX 4090 | NVIDIA H100 | NVIDIA H20 | 昇腾910B |
|---|---|---|---|---|
| 显存 | 24GB GDDR6X | 80GB HBM3 | 96GB HBM3 | 64GB HBM2e |
| 显存带宽 | 1,008 GB/s | 3.35 TB/s | 4.0 TB/s | ~1.6 TB/s |
| FP16算力 | ~330 TFLOPS | ~990 TFLOPS | ~148 TFLOPS | ~320 TFLOPS |
| NVLink/互联 | 不支持 | NVLink 900GB/s | NVLink 900GB/s | HCCS 392GB/s |
| 单卡租赁参考价(元/时) | ~8-15 | ~45-65 | ~35-50 | ~25-40 |
| 架构 | Ada Lovelace | Hopper | Hopper | 达芬奇 |
| 适用场景 | 微调/推理/开发 | 预训练/微调 | 微调/推理 | 推理/信创训练 |
2.1 显存:大模型的第一道门槛
对于大模型训练和推理,显存往往比算力峰值更重要。以LLaMA-70B模型为例,FP16精度下模型参数占用约140GB显存,加上优化器状态和梯度存储,单卡训练基本没有可能性——必须依赖多卡并行。RTX 4090的24GB显存在这一场景显得捉襟见肘,但用于LLaMA-7B/13B级别的模型微调(LoRA/QLoRA方式)则绰绰有余。
H100的80GB HBM3显存带宽达到3.35TB/s,在千卡集群中通过张量并行+流水线并行的组合策略,可以在合理时间内完成千亿参数模型的预训练。H20的96GB显存是个有趣的设计——计算能力被限制但显存参数保持高位,这使其在"大显存需求但算力要求不高"的推理场景中找到了定位缝隙。昇腾910B的64GB HBM2e在显存容量和带宽上与H100存在代差,但在70亿到130亿参数级别的模型推理中表现可圈可点。
2.2 互联带宽:多卡扩展的瓶颈
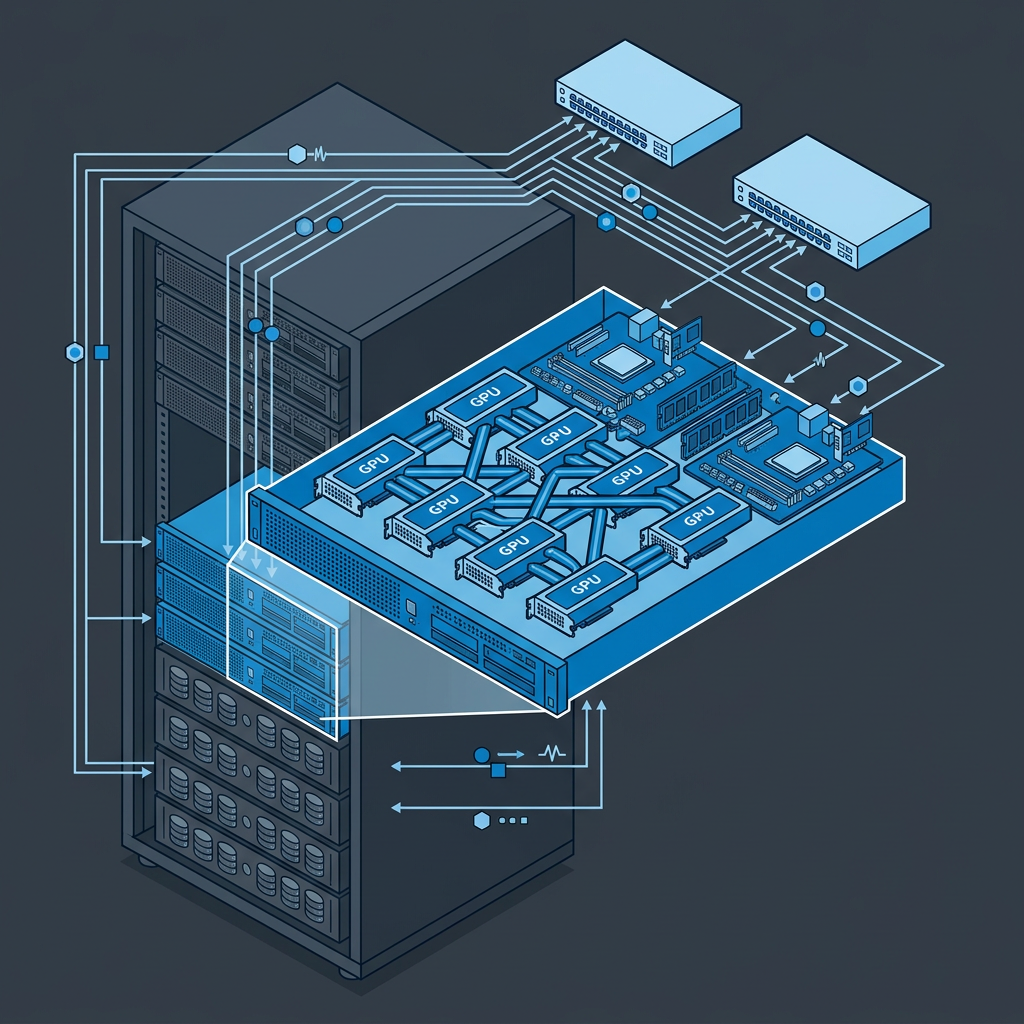
在单机8卡场景中,GPU之间的通信带宽直接影响分布式训练效率。H100和H20通过NVLink Switch支持单机内900GB/s的双向带宽,配合InfiniBand/RoCE实现跨节点通信——这是RTX 4090无法企及的能力。RTX 4090不支持NVLink,多卡通信依赖PCIe 4.0×16(约64GB/s单向),在大规模分布式训练中会成为严重瓶颈。
昇腾910B的HCCS互联方案(Hierarchical Cache Coherence System)提供约392GB/s片间带宽,与NVIDIA的NVLink方案相比仍有差距,但通过华为自研的CANN软件栈进行通信优化后,在百卡规模内的扩展效率接近H100的75%-85%。对于百卡到千卡级别的超大规模集群,这一差距会被放大,也是当前国产算力在预训练场景的主要短板之一。
三、成本效率:三张卡的真实账单
只看技术参数是工程师思维,加上成本才是企业采购思维。以下通过三个典型场景的TCO(总拥有成本)分析来呈现真实账单。
场景一:LLaMA-7B全参数量微调(约需4 GPU卡时)
RTX 4090方案:4×12元×1小时=48元。H100方案:4×55元×1小时=220元。成本差距约4.6倍,但训练耗时差距不到2倍——在这个场景中,4090的性价比优势非常明确。
场景二:LLaMA-70B QLoRA微调(约需2 GPU卡时,要求48GB+显存)
RTX 4090因显存不足直接出局。H100方案:2×55元×1.5小时≈165元。H20方案:2×42元×2小时≈168元。昇腾910B方案:2×32元×2.5小时≈160元。三者总成本接近,H100在绝对速度上有优势。
场景三:千亿参数模型预训练(256卡×30天)
这是只有H100规模集群才能高效完成的任务。256张H100×55元×720小时≈1014万元。使用RTX 4090集群因互联瓶颈导致的效率损失将使总成本翻倍甚至更高。在这个场景中,H100的高单价被其分布式训练效率所对冲。
这些成本估算印证了一个规律:算力租赁平台上的GPU选型没有"最好的卡",只有"最适配的卡"。场景定义需求,需求决定选型。更多成本对比数据可以参考2026年GPU租用平台价格全对比。
四、模型适配性:软件生态的实际差距
GPU硬件参数在纸上可能差距不大,但落到实际模型训练中,软件生态的成熟度差异会显著拉大体验鸿沟。
CUDA生态是NVIDIA三款卡的护城河。绝大多数开源大模型(LLaMA、Mistral、Qwen、DeepSeek等)的官方实现默认支持CUDA,PyTorch对CUDA的原生支持意味着模型可以直接跑,几乎不需要做适配工作。H100、H20、RTX 4090在这个维度上没有本质区别——都能享受CUDA生态的便利。
昇腾910B的适配路径则相对复杂。华为提供的MindSpore框架和CANN(异构计算架构)工具链提供了PyTorch模型到昇腾的迁移方案,但在实际工程中,算子兼容性检查和性能调优仍然需要相当的工程投入。好消息是2026年这个差距在快速缩小——CANN 6.0+版本对PyTorch 2.x的兼容度已经覆盖了主流的Transformer算子,Ascend原生支持的模型列表从2025年初的几十个扩展到超过200个。参考NVIDIA H100 vs 华为昇腾910B在算力租赁平台上的真实表现可以了解更详细的实测数据
五、企业选型决策框架
✅ RTX 4090:中小企业入门和研发迭代首选
适用:7B-13B模型微调、RLHF、推理服务、算法验证。日均成本控制在千元以内。
局限:不支持多卡高效并行训练,24GB显存限制了模型规模上限。
✅ H100:大规模预训练的"标准答案"
适用:千亿参数模型预训练、百卡以上分布式训练、对训练效率有极致要求的场景。
局限:单价高,小规模使用时性价比不突出。
✅ H20:合规场景下的推理与微调替代方案
适用:需要H100生态但受限于合规要求的场景,96GB显存在推理场景中有优势。
局限:计算能力被大幅限制,不适合预训练场景。
✅ 昇腾910B:国产替代和推理部署的价值锚点
适用:信创合规需求、推理服务部署、预算敏感且模型规模适中的训练场景。
局限:软件生态适配需要额外工程投入,超大规模分布式训练效率存在短板。
常见问题(FAQ)
六、总结
GPU选型的思维起点不应是"哪张卡最好",而是"我的模型、我的预算、我的场景最适配哪张卡"。在算力租赁平台的灵活租用模式下,企业不需要在四种GPU中做唯一的单选题——按场景拆解算力需求,用H100做重训、4090做迭代和推理、国产卡覆盖信创场景,是越来越多企业AI团队的实战配置。
选型决策可以参考以下顺序:先确认模型规模→推算显存需求→评估是否需要多卡互联→根据预算约束做成本效率对比→留出POC验证的时间窗口。