
GPU服务器租赁全流程指南:从按小时租用到包年包月怎么选
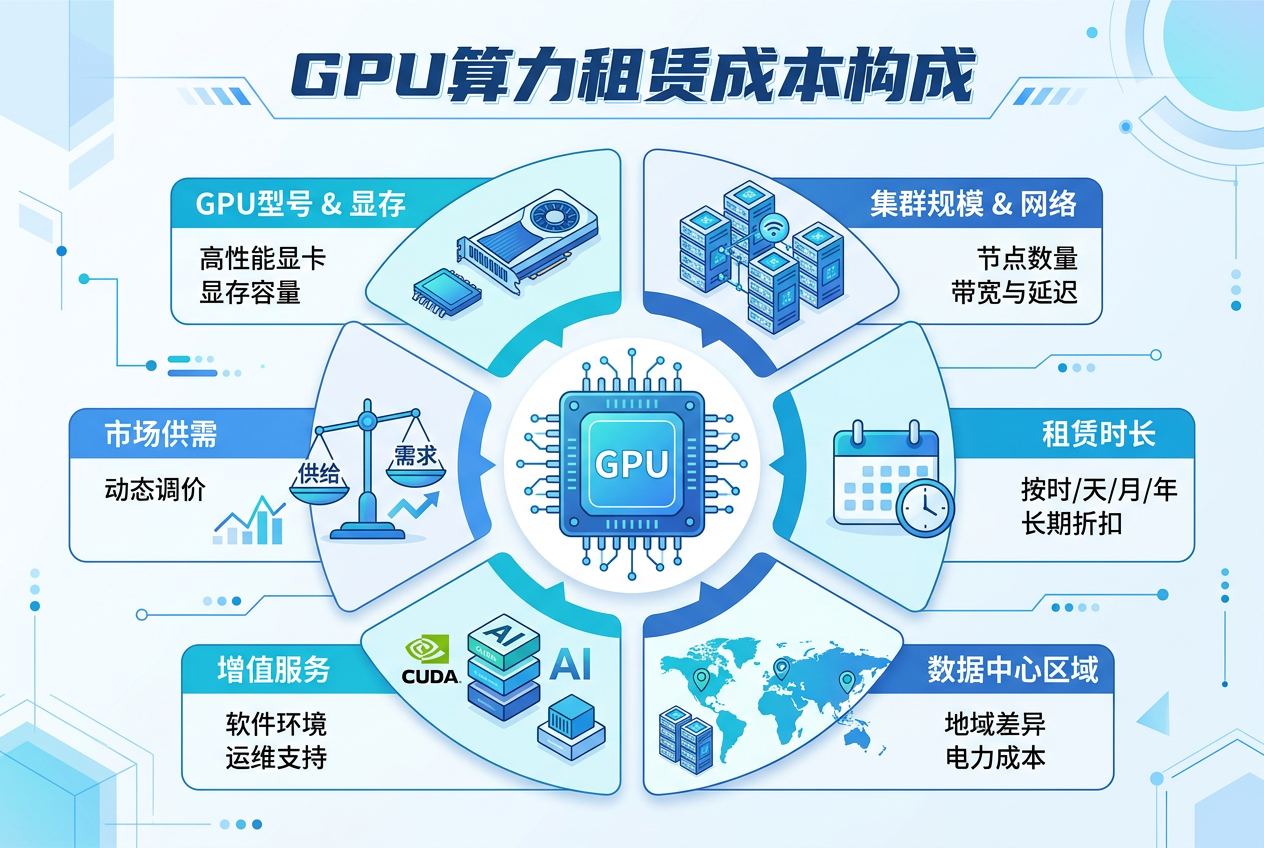 GPU服务器租赁全流程指南:从按小时租用到包年包月怎么选
无论是临时跑一个模型验证,还是搭建长期推理服务管线,GPU服务器租赁已成为AI从业者的基础设施。但gpu服务器小时租用和包月/包年到底怎么选?中间的切换时机如何判断?本文提供一份完整的实操指南。
一、GPU服务器租赁的四种计费模式对比
核心判断公式:如果每天有效使用GPU >= 16小时 × 每月 >= 22天,包月比按小时划算。如果< 8小时/天,按小时弹性租用更经济。
二、GPU服务器租赁完整流程(六步走)
Step 1:明确算力需求
模型参数量决定显存需求,训练/推理场景决定GPU型号选择,数据量决定存储和网络带宽需求。建议先用公式估算:所需显存 ≈ 模型参数 × 4 (FP32) + 优化器状态 + 激活值。
Step 2:选择GPU型号与卡数
千亿参数模型需要H100 80G多卡集群;7B-13B微调A100 40G/80G足够;小型任务RTX 4090性价比最高。关键原则:先单卡跑通流程,再扩展到多卡。
Step 3:确定计费模式
新项目先用gpu服务器小时租用做2-3天POC验证。验证通过后估算月度需求,再决定是否切换包月。避免一上来就锁定资源。
Step 4:环境配置与镜像部署
选择预装CUDA + PyTorch + JupyterLab的现成镜像,或上传自定义Docker镜像。环境搭建时间也计入计费,尽量选择预置环境。
Step 5:数据上传与训练启动
数据集提前上传到云存储,训练时直接挂载,避免每次创建实例都重新上传。建议用tmux/screen或Notebook保持长连接,防止SSH断开导致训练中断。
Step 6:结果导出与资源释放
训练完成后立即导出checkpoint,并释放/关机GPU实例。未释放的实例会持续计费,这是算力服务器租赁中最常见的浪费来源。
三、GPU裸金属 vs GPU容器实例怎么选
在选择GPU服务器租赁产品形态时,还需区分裸金属(Bare Metal)和容器实例:
四、从小时租用到包月切换的时间点判断
以下情况的出现,标志着应该从gpu服务器小时租用切换为包月租赁:
- 连续2周每天使用GPU >= 8小时
- 训练任务进入稳定迭代阶段,预计还需1-3个月
- 推理服务上线,需要7×24可用
- 多人团队协作,共享GPU资源池
五、降低GPU服务器租赁成本的实战技巧
- 善用竞价实例:部分平台提供竞价/可抢占实例,价格仅为常规实例的30%-50%,适合可容忍中断的离线训练任务。
- 混合使用多种计费模式:日常开发用按小时,正式训练用包月,推理服务用低配包年。一个团队不需要单一计费策略。
- 定期审计GPU使用率:每周检查GPU利用率,及时释放闲置实例。闲置一台A100 80G每月白白损失数千元。
- 选择合适的GPU代际:很多推理任务用上一代A100 40G足够,不需要为最新H100支付溢价。
2026年GPU服务器租赁市场日趋成熟,从小时租用到包年包月,从裸金属到容器实例,选择空间前所未有地丰富。关键是根据实际任务需求做出匹配的决策,而非盲目追求最贵或最便宜的方案。
提示:本文仅提供决策框架。具体gpu服务器租用报价、可用GPU型号和地域覆盖,请以极智算官网实时信息为准。建议先体验不同计费模式再确定长期方案。
标签:
立即咨询极智算客服,获取专属您的2025年GPU服务器配置与报价方案,开启高效算力之旅!