RTX 4090显卡服务器租用完全指南:规格、价格与适用场景深度解析
一句话总结:如果跑的是7B-13B模型的推理或LoRA微调,4090的性价比很难被超越——FP16推理速度比A100还快一点,但租金只要A100的1/3到1/4。超了这个范围,24GB显存就开始捉襟见肘了。
一、RTX 4090 为什么在AI圈这么受欢迎
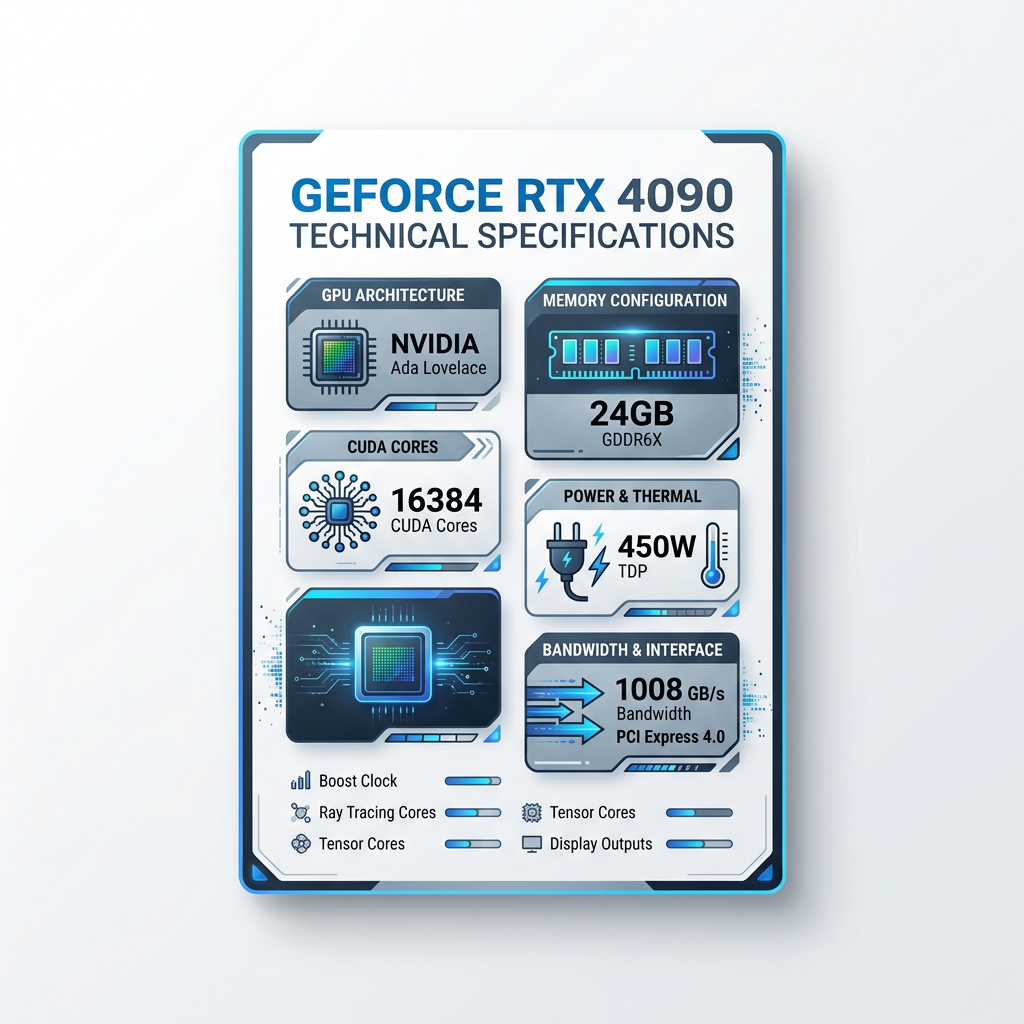
NVIDIA RTX 4090(AD102核心)本来是给游戏市场做的,搭载Ada Lovelace架构,24GB GDDR6X。但它在AI推理中的表现意外地好——FP16算力达到330 TFLOPS,超过了A100的312 TFLOPS。加上一张卡月租只相当于A100的零头,成了很多中小团队做AI开发的入门首选。
从2024年开始,各大GPU租赁平台陆续上架了4090。主打的卖点就是"低成本AI算力"。但4090不是所有场景都适合——显存只有24GB、没有NVLink互联、也没有ECC显存,这几个限制直接决定了它的适用范围。租之前先搞清楚这些,能少踩很多坑。
二、规格参数
NVIDIA RTX 4090 主要参数
4090 与 A100、H100 对比
| 参数 | RTX 4090 | A100 80GB | H100 80GB |
|---|---|---|---|
| 显存 | 24GB | 80GB | 80GB |
| 显存带宽 | 1,008 GB/s | 2,039 GB/s | 3,350 GB/s |
| FP16算力 | 330 TFLOPS | 312 TFLOPS | 989 TFLOPS |
| NVLink | 不支持 | 600 GB/s | 900 GB/s |
| ECC显存 | 不支持 | 支持 | 支持 |
| 功耗 | 450W | 400W | 700W |
| 租赁月费(参考) | 约1200-1800元 | 约8000-12000元 | 约50000-65000元 |
RTX 4090 长处
- 租金低,单卡月费约1200-1800元
- FP16推理速度略超A100
- 单卡或双卡训练够用
- 机器起配门槛低
- 按小时计费,灵活
RTX 4090 短板
- 24GB显存,70B+模型装不下
- 没有NVLink,多卡效率差
- 没有ECC,不做金融/科学计算
- 消费级硬件,长期稳定性不如A100/H100
- 有些平台是vGPU,性能和物理卡差一截
三、适用场景
适合做:
- AI推理服务:7B-13B模型在线推理(LLaMA-2-7B、Qwen-7B这些),单卡4090能撑起百万级日请求
- 小模型微调:LoRA/QLoRA微调13B及以下模型,24GB够用
- 原型开发和实验:算法工程师日常调试、跑实验,成本低又够快
- 计算机视觉:图像分类、目标检测、Stable Diffusion出图
- 学生/个人开发者:预算有限但需要GPU
不太适合:
- 大模型全量训练(>13B):70B模型全参数要将近140GB显存(FP16),24GB连塞都塞不进去
- 多卡分布式训练:没有NVLink,卡间通信靠PCIe,训练效率骤降
- 金融级精度:没有ECC显存,数据一致性没法保证
- 7×24关键任务:4090是消费级硬件,长期跑满的稳定性不比A100
四、4090租赁价格与计费方式
| 计费方式 | 参考价格区间 | 适用场景 |
|---|---|---|
| 按小时 | 约2.0-3.5元/小时 | 短期测试、弹性推理 |
| 按天 | 约40-70元/天 | 周末训练、短期项目 |
| 包月 | 约1200-1800元/月 | 持续训练、长期推理 |
| 包年 | 约12000-18000元/年 | 长期稳定需求,通常85折 |
五、租用4090需要注意的事
- 先确定是物理卡还是vGPU:物理卡性能完整,vGPU可能只剩物理卡1/2甚至1/4的性能
- 配套硬件要跟上:CPU不少于8核、内存不少于32GB、系统盘NVMe不少于100GB,这些拖后腿比GPU慢更难受
- 网络带宽:数据量大的话,出口带宽和流量费在报价里往往放在不起眼的地方
- CUDA版本和驱动:确认平台的CUDA版本和你用的PyTorch/TensorFlow兼容
- 散热和稳定性:4090功耗450W,散热不够会触发降频。正规平台用数据中心级散热方案解决这个问题
- 商业用途合规:部分平台的4090因为是消费级显卡,数据中心部署和商业使用需要确认合规性
极智算提供RTX 4090物理显卡租赁,按小时/包月灵活计费
查看4090租赁方案 →六、按场景的推荐配置
| 使用场景 | 推荐GPU配置 | 计费方式 |
|---|---|---|
| 7B模型推理 | 4090 × 1 + 32GB内存 | 按小时/包月 |
| 13B模型LoRA微调 | 4090 × 1 + 64GB内存 | 包月 |
| SD图像生成服务 | 4090 × 1 + 16GB内存 | 按小时 |
| 多模型并行推理 | 4090 × 2 + 64GB内存 | 包月 |
| 70B+模型训练 | 不建议4090,上A100/H100 | — |
七、总结
RTX 4090扮演的是入门级高性能GPU的角色。预算有限的中小团队、独立开发者和学生用它做推理和微调,性价比是所有方案里最高的。但24GB显存和没有NVLink,意味着在70B+大模型全量训练上不适合用它去将就——效率会非常差。
4090的好不在于它最强,在于在大多数日常场景下它的性价比很难被超越。
八、常见问题
Q1:RTX 4090和A100做推理,哪个好?
7B-13B模型单卡推理的话,4090的FP16算力(330 TFLOPS)比A100(312 TFLOPS)略高,租金只有A100的1/3到1/4。所以纯推理场景下,4090的性价比好得多。但如果模型超过24GB显存,或者需要多卡并行推理,A100更合适。
Q2:4090能训练70B大模型吗?
直接全量训练基本不行——70B模型全参数约需140GB显存(FP16),是24GB的将近6倍。即使用QLoRA(4-bit量化)+ DeepSpeed ZeRO-3这些极端优化手段勉强跑起来,速度也会非常慢。不建议这么用。70B级训练应该选A100 80GB或H100。
Q3:两张4090能当一张A100用吗?
不能。两张4090显存加起来48GB,看起来快赶上A100的40GB,但4090没有NVLink,卡间通信走PCIe 4.0,带宽只有A100 NVLink的1/10。分布式训练时通信开销会吃掉大部分性能,实际可能只有A100一半左右的训练速度。
Q4:选4090平台时主要看什么?
三个点:(1) 物理卡还是vGPU;(2) 配套CPU和内存匹不匹配(别高显低配);(3) 平台是否预装CUDA和驱动。先用显卡租赁平台评估指南做基础筛选。
Q5:4090跑生产推理稳定吗?
7B-13B模型的推理服务,4090完全能胜任,而且成本低。但如果是7×24高可用的生产系统,建议上A100这类数据中心级GPU。4090的硬件设计寿命和长期稳定性弱于企业级GPU,而且部分平台不支持热迁移和故障自愈。
— 本文由 JYGPU 极智算 编写