
算力租赁平台容器实例实操:按小时租4090跑大模型,从开机到推理的全流程成本拆解
去年这时候,中小企业搞大模型部署,第一反应还是"买卡"或者"包年租服务器"。今年风向变了——按小时租GPU算力成了新常态。这种变化不是宣传出来的,是价格降下来以后自然发生的。
今天这篇文章不聊趋势,纯实操。用jygpu.com上的4090容器实例(¥1.96/时)从头跑一遍:创建实例 → 配置CUDA环境 → 部署Qwen2.5-7B → 压测推理性能 → 算钱。每一步都有对应的命令和实际耗时,方便技术团队复现。
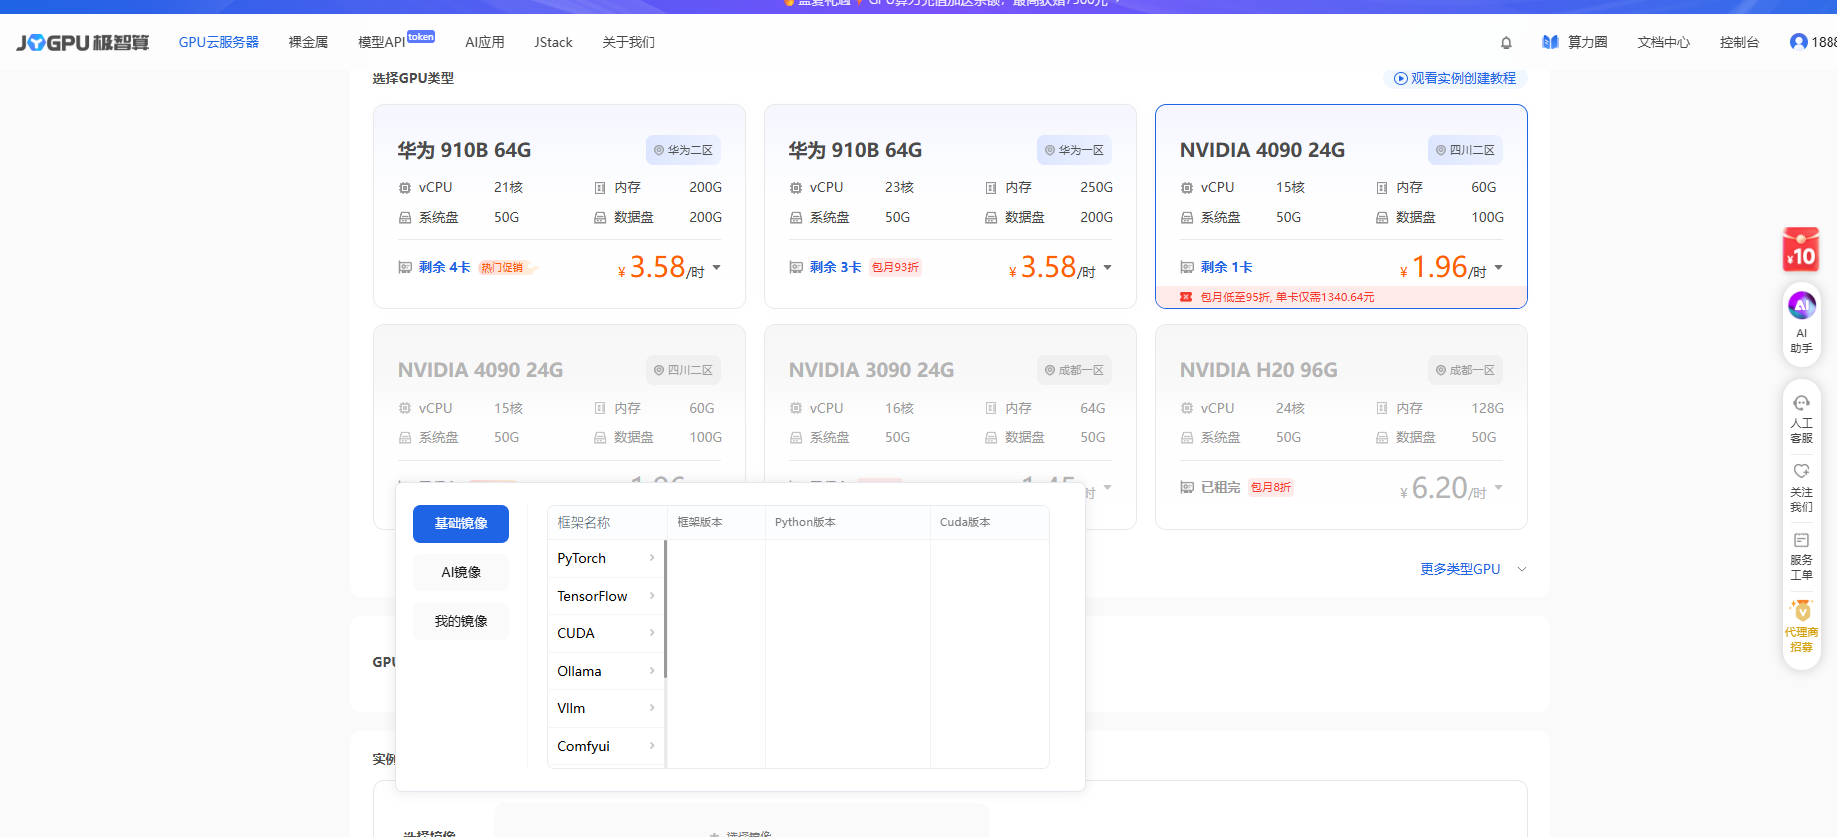
第一步:创建4090容器实例(耗时约90秒)
在JYGPU算力市场选择"容器实例"→ 4090 → 选择基础镜像。jygpu.com提供了三种预装镜像:
- CUDA 12.1 + PyTorch 2.2.0(推荐,生态兼容性最好)
- CUDA 12.4 + PyTorch 2.4.0(最新版,支持Flash Attention 2)
- Ubuntu 22.04 裸系统(完全自定义,适合有标准镜像的团队)
选择CUDA 12.4 + PyTorch 2.4.0镜像,数据盘50GB(默认可扩容),点击创建。不到两分钟,SSH连接信息就推送到注册邮箱了。速度比AWS的GPU实例启动快了不止一个量级——主要原因是预装了CUDA驱动和Python环境,跳过了最耗时的环境配置环节。
第二步:SSH登录 + 验证GPU状态
从创建实例到SSH连入、验证GPU,全程3分钟内搞定。这个速度对有紧急任务需求——比如临时接了客户PoC、或者模型突然需要热更新——的团队来说很关键。过去自建集群从申购到上架最短也要2周。
第三步:部署Qwen2.5-7B模型并启动推理服务
这里选用vLLM作为推理框架。vLLM在4090上的PagedAttention内存效率表现不错,7B模型能压到12~14GB显存占用。下面是完整部署流程。
模型下载花了大概8分钟(取决于模型大小和网络带宽),vLLM启动30秒。整个过程15分钟内可以从零到一个可调用的推理API。对于PoC验证来说,这个效率意味着一天可以跑2~3轮模型对比测试。
第四步:压测推理性能
用vLLM自带的benchmark工具做一轮简单压测,模拟真实调用场景。
这个性能对大部分B端场景——客服机器人、文档摘要、代码辅助——完全够用。如果业务需要更高QPS,有两类方案:一是加卡做负载均衡(2×4090容器 ¥3.92/时,QPS翻倍到~44);二是切裸金属8卡做分布式推理(方案对比见《算力租赁平台裸金属方案深度拆解》)。
全流程成本拆解
回到大家最关心的数字。下面是把整个流程的每一项成本拆出来算。
* 按¥1.96/时 = ¥0.0327/分钟计算
不到五毛钱跑完一次完整的模型部署验证。这个数字放在自建集群上完全没有参考价值——自建集群的一次性投入(机房、电力、网络、运维人力)摊销下来,单次部署验证的成本至少在两百元以上,还不算时间成本。
接下来算生产环境的运营成本:
* 万次推理成本 = 月成本 / (QPS × 3600 × 24 × 30) × 10000,实际值受请求长度、批处理策略影响。
容器 vs 裸金属:什么时候应该切方案?
很多团队用了一段时间容器后会问我同一个问题:"什么时候应该从容器切到裸金属?"
判断标准可以简化成两条:
- 日GPU使用时长:如果4090容器的日使用时长稳定超过18小时,裸金属8卡¥7,920/月的方案更划算。按¥1.96/时 × 18小时 × 30天 = ¥1,058,单卡成本已经接近裸金属单卡的¥990/月了。
- 多卡通信需求:一旦上多卡训练,容器的网络层会引入额外延迟。裸金属的物理互联(NVLink/NVSwitch)是容器方案无法替代的。关于这点,我们在《算力租赁平台GPU选型实测》中有详细的通信效率对比数据。
🎯 一句话建议:推理+PoC用容器(¥1.96/时4090),训练+长稳生产用裸金属(¥7,920/月4090×8)。两者在算力租赁平台上可以无缝切换,不需要重做环境配置。
这也是容器化GPU部署方案最大的优势:从4090容器验证方案 → 确认后切同型号裸金属包月 → 业务增长后加卡扩容,全程不需要改造模型代码或更换推理框架。对于技术团队来说,这省下来的不是钱,是精力。
回到最开始的话题。一年前中小企业搞大模型,只能咬牙买卡或者签年框。现在按小时租GPU算力把门槛拉到了五毛钱做一次完整验证。这个变化对B端的影响放在更长的时间尺度上,会体现在两件事上:一是AI产品的试错成本大幅降低,二是技术决策从"拍脑袋定配置"变成了"拿数据跑一轮再说"。
JYGPU算力市场(jygpu.com/markets)的4090容器实例¥1.96/时,H20容器¥6.20/时,910B容器¥3.58/时,全部支持按小时计费、分钟级启动。建议先开一台4090把本文的流程跑一遍——五毛钱的试错成本,换一个拿数据说话的决策依据。