
算力租赁平台GPU选型实测:4090/H20/H100三卡真实价格、性能差距与租用场景全对比(2026年7月)
一周接待了三拨来问"到底租哪张卡"的技术团队。问题基本一致:预算有限,任务明确,卡在4090、H20、H100之间做不了决定。
这个问题三年前不存在——那时候能租到卡就不错了。现在算力租赁平台上型号多了、价格也打下来了,选型反而成了新难题。本文把这三张卡在jygpu.com上的真实报价、性能参数、适用场景掰开揉碎讲一遍,希望读完能让你少跑两轮PoC。
FP16: 82.6 TFLOPS
消费级架构
FP16: 148 TFLOPS
数据中心级
* 价格来源:jygpu.com 算力市场,截至2026年7月27日实时报价。
三张卡到底差在哪:一个参数表说清楚
数据摆出来就很清楚了。4090和H20/H100之间的差距不是"便宜一点"和"贵一点",而是完全不同的产品线:4090是消费级显卡,H20/H100是数据中心级GPU。核心差异在三个方面。
差异一:显存 —— 决定你能跑多大的模型
显存大小直接决定了单卡能加载的模型参数规模。
- 4090的24GB显存:FP16精度下,模型参数每10亿大约占用2GB显存。也就是说4090单卡最多跑10B参数的模型。考虑KV Cache和激活值开销后,实际能稳定推理的模型大约在7B参数。跑个Llama 3 8B、Qwen 7B没问题,Llama 3 70B就必须用量化或者多卡张量并行了。
- H20的96GB HBM3:96GB显存,单卡FP16能装下约45B参数的模型。70B模型开INT8量化后也能塞进单卡。这比4090的两卡方案在推理延迟和部署复杂度上都要省很多事。
- H100的80GB HBM3:单卡容量比H20少一点,但HBM3带宽3,350GB/s是H20的1.7倍左右,是4090的3.3倍。训练场景下,带宽比容量更关键——大批量数据在GPU和显存之间的搬运速度直接影响训练吞吐。
"显存够不够"是选卡的第一道门槛。模型参数 × 2 ≈ 所需显存(FP16),留15~20%余量给KV Cache和中间张量。
差异二:多卡互联 —— 决定你能不能把训练跑起来
这是最容易被忽视的差异,也是4090 GPU租用性价比这个命题里最大的暗坑。
4090不支持NVLink。两张4090之间走PCIe 4.0 ×16,双向带宽大约64GB/s。H20和H100通过NVSwitch互联,单链路900GB/s,8卡全互联等效带宽远超PCIe方案。训练场景中做梯度同步(All-Reduce)操作时,这个差距会被指数级放大。
举个例子:用8卡做70B模型的LoRA微调。4090 PCIe方案通信时间占总训练时间的比例可能在30%以上,而H100 NVSwitch方案这个比例低于5%。换句话说,4090集群有将近三分之一的时间在等数据搬运,H100集群几乎满负荷运转。
所以结论很直接:
- 需要用两张以上卡做训练 → 4090不是好选择。
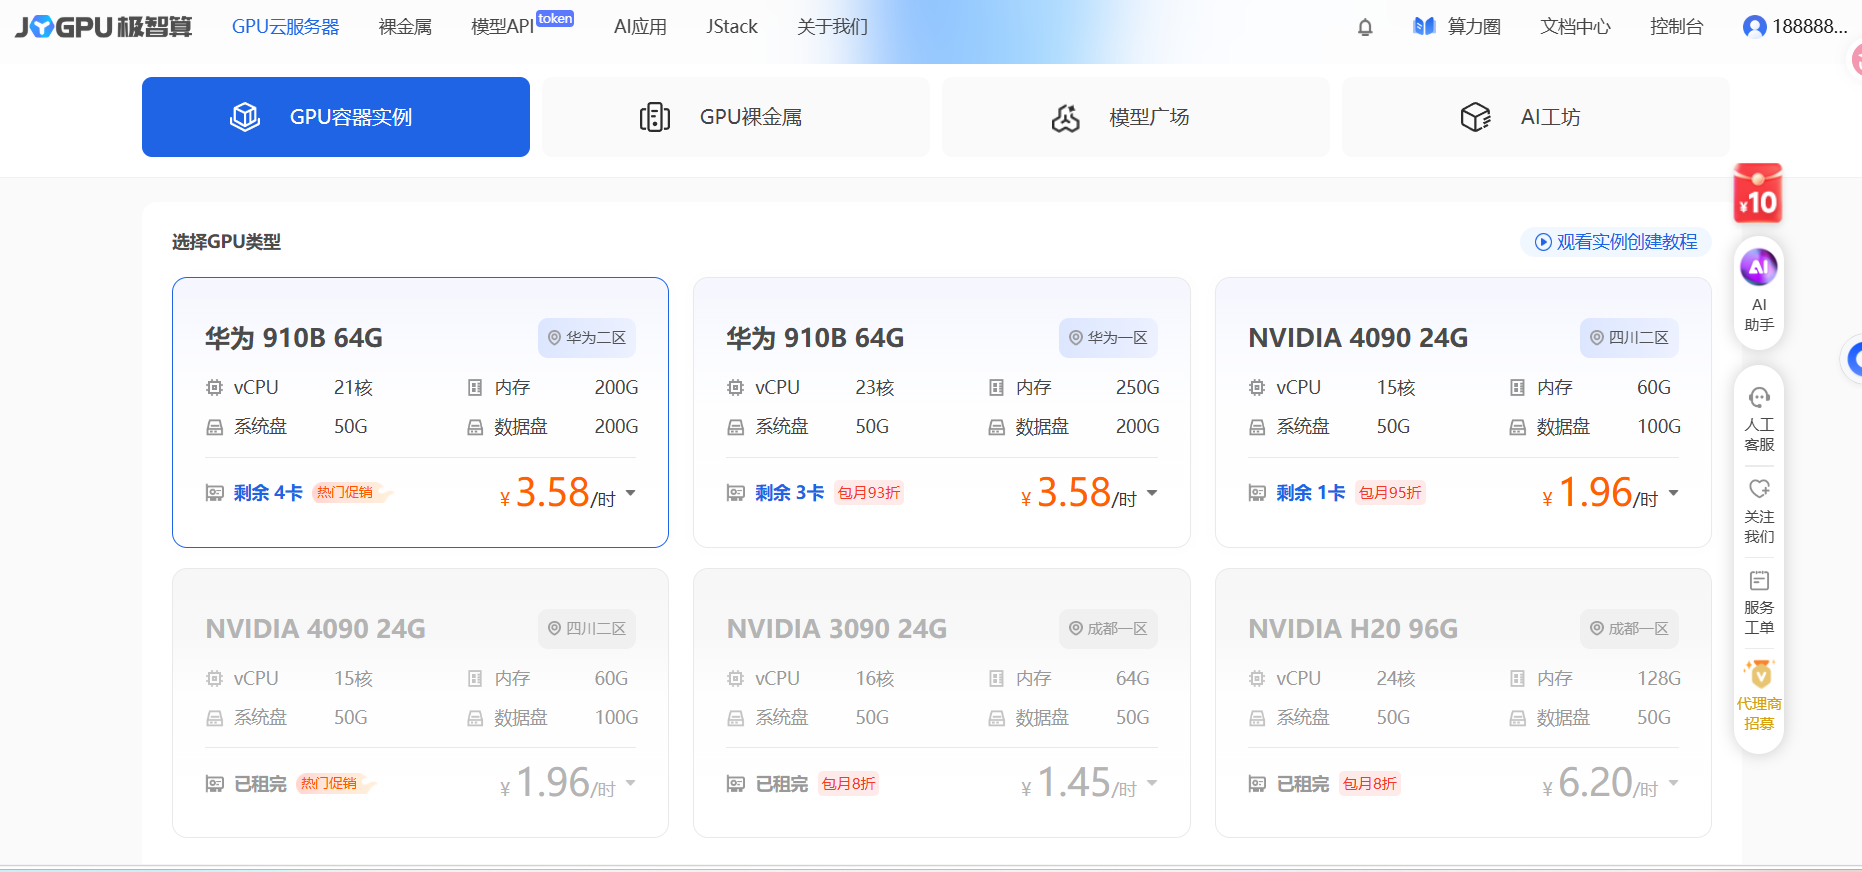
- 单卡推理或单卡微调 → 4090的¥1.96/时是市面上能找到的最低价格。
差异三:价格——算的不是单价,是任务总成本
这里做两道简单的算术题。
场景一:部署一个7B模型的在线推理服务,峰值QPS=30。
一张4090跑7B模型,保守估计QPS=20~30。需要1张卡。月成本 = ¥1.96 × 24 × 30 = ¥1,411。如果选H20,月成本 = ¥6.20 × 24 × 30 = ¥4,464。3.2倍的价差。这个场景选H20没有任何道理。
场景二:用8卡做70B模型的全参数量微调,预计训练时间120小时。
4090裸金属8卡 = ¥7,920/月(720小时),120小时折算成本 ≈ ¥1,320。
H100裸金属8卡 = ¥84,480/月,120小时折算成本 ≈ ¥14,080。
但别忘了:4090的PCIe通信开销让120小时实际可能变成160~180小时——甚至更多。H100的NVSwitch互联可以把通信开销压到最低。训练结果的质量和收敛速度也有差异。
所以问到H100 GPU租赁费用对比时,我的回答总是:算总账,别算单价。训练场景的隐性成本(通信等待、收敛速度、调参轮次)加起来往往远超显性价格差。
三张卡的最佳场景速查
7B-13B模型在线推理:4090容器 ¥1.96/时 → 月成本约¥1,400,性价比无人能及
70B模型推理(量化):H20容器 ¥6.20/时 → 96GB显存单卡搞定,免去多卡部署的运维负担
7B模型全参数微调(单卡):4090容器 ¥1.96/时 → 24GB显存刚好够用,性价比拉满
70B模型LoRA微调(单卡):H20容器 ¥6.20/时 → 96GB显存,LoRA配置下绰绰有余
70B-100B模型全参数预训练(多卡):H100 裸金属8卡 ¥84,480/月 → NVSwitch互联是刚需,省不掉
百亿参数模型推理 + 信创要求:910B裸金属8卡 ¥15,600/月 → 国产替代场景下性价比突出
一个真实的踩坑案例
上个月一家做AI法律助手的公司找到我们。他们的需求是"部署Llama 3 70B做法律文书审核"——纯推理场景,日均QPS大约15。
他们原本打算租H100裸金属8卡,月预算是8万多。我们建议先用4090容器做一轮压测——结果发现用vLLM框架、INT8量化、单张4090就能跑,QPS稳定在18~22,延迟不到800ms。
最终方案从H100×8的月费¥84,480,变成了4090×1的月费约¥1,400。降了将近98%。
这不是说H100不好,而是说"场景不匹配"比"硬件不够"造成的浪费更大。类似的GPU选型方法论,我们在《算力租赁平台容器实例实战:按小时租GPU跑大模型全流程成本拆解》和《算力租赁平台裸金属方案深度拆解》中有更详细的操作指南。
回到那句话:算力租赁平台上有卡可选是好事,但选错卡的代价远超租卡的单价。花半小时搞清楚自己的任务是算力密集型还是通信密集型、是训练场景还是推理场景,比找个最低报价重要得多。
JYGPU算力市场(jygpu.com/markets)同时提供4090、H20、H100、910B四种GPU的容器和裸金属方案,所有报价实时更新。建议先按小时租做验证,确认方案后再转包月——这是我们在几十个技术团队身上验证过的最安全路径。