
中小企业AI算力怎么选?从入门到进阶的完整方案(2026版)
不是每家公司都像字节跳动那样日调用120万亿Token。
大部分中小企业做AI的真实处境是:老板说"我们也搞个AI",预算给了5万,团队一个人,还要兼做其他开发。GPU?听说过A100很厉害,但不知道适不适合自己。
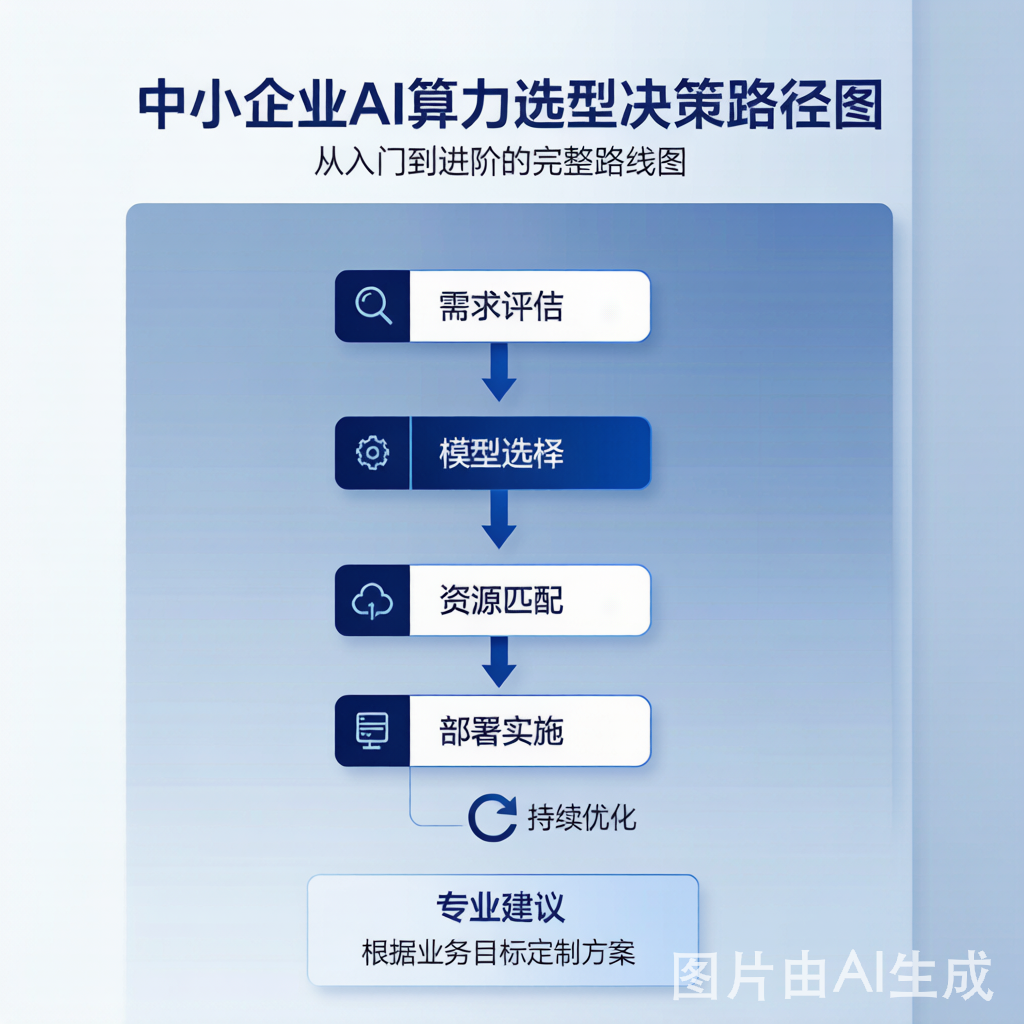
我梳理了三套方案,从月预算1000元到10万元,覆盖不同阶段的AI算力需求。
方案一:验证阶段(月预算1000-5000元)
这个阶段的典型场景:试试大模型能不能用在自家业务上,跑个Demo给老板看,验证一下想法。
算力配置建议:
- GPU:1-2张Tesla T4(16GB显存)或RTX 3090(24GB显存)
- 月租成本:1000-3000元
- 适合做什么:跑7B参数的开源模型(Llama、Qwen、DeepSeek等)做推理测试,小规模微调(LoRA),Stable Diffusion出图
或者直接用API:
- DeepSeek-V3 API:1元/百万Token输入
- GLM-4-Flash:免费
- 月消耗:几百到一千块
这个阶段不建议买任何硬件。租GPU或直接调API就够了。万一方向验证不通,沉没成本最低。
真实案例:一家电商公司想测试AI客服,租了2张T4(月租2000元),部署了一个7B的对话模型,接上公司产品文档做RAG。跑了两周发现效果不错,才开始规划正式部署。
方案二:落地阶段(月预算5000-30000元)
验证通过,准备把AI真正用到业务里了。
算力配置建议:
- GPU:2-4张RTX 4090(24GB显存)或2张A100(80GB显存)
- 月租成本:5000-20000元
- 适合做什么:7B-13B模型的LoRA微调、推理服务部署、小规模RAG应用
Token租赁补充方案:
- 推理场景为主:租2张4090做自部署模型(月租3000-5000元)+ API调用做兜底
- 训练场景为主:租4张4090或2张A100(月租8000-20000元)
这个阶段的选型技巧:
- 如果主要做推理,4090比A100划算。4090的推理性能和A100差距不大,但价格只有1/4。
- 如果涉及训练,A100的显存带宽优势就出来了。同样训一个7B模型,A100比4090快30%-50%。
- 混合使用:推理用4090,训练用A100或H100。
方案三:规模阶段(月预算30000-100000元)
业务跑通了,用户量上来了,需要稳定的生产级算力。
算力配置建议:
- GPU:4-8张A100或H100
- 月租成本:30000-100000元
- 适合做什么:13B-70B模型训练、高并发推理服务、多模型并行部署
这个阶段可以开始考虑"租为主、买为辅"的混合策略:
- 核心训练任务租H100(效率优先)
- 日常推理服务可以考虑采购几台4090服务器(成本优先)
- 弹性需求继续走租赁
五条给中小企业的实操建议
1. 先用API,后租GPU,最后才考虑买
这个顺序不要反。很多公司一上来就买卡,结果发现业务根本不需要那么多算力,卡在机房里吃灰。
2. 别在模型大小上钻牛角尖
7B模型在很多场景下效果不比70B差太多,但成本差了10倍。先跑通业务逻辑,再考虑升级模型。
3. 关注国产GPU
华为昇腾910B、寒武纪MLU370已经在不少场景下可用,价格比NVIDIA同级产品低30%-50%。如果你的业务不依赖CUDA生态的特殊算子,国产卡是很好的替代选项。
4. 选平台看三点:价格透明、环境预装、客服响应
这个前面几篇文章反复提过,但对中小企业尤其重要——你没有专门的运维团队,环境配置、故障排查都得自己来。平台能不能帮你省掉这些麻烦,比单价便宜几毛钱重要得多。
5. 预留20%的算力预算给实验
AI项目最大的成本不是算力,是方向试错。留出预算给A/B测试、新模型评估、技术预研。这笔钱不花,你可能一直在用一个次优方案。
最后说点实在的。
2026年做AI,算力不是瓶颈,选择才是。GPU贵但能租,模型多但知道怎么选的人少。中小企业最大的优势是决策快、转向快——租两台4090,花两天跑个Demo,行不行一周内就知道了。这套打法,大公司学不来。