
AI大模型API Token租赁完全指南:比直接调官方API便宜一半的秘密
大模型API的价格战打到2026年,局面已经彻底变了。
DeepSeek把百万Token输入压到1块钱,GLM-4-Flash直接免费开放。另一边,豆包C端开始收费,68-500元/月的订阅制让"免费午餐"时代走向终结。
但有个问题很少人注意到:直接调官方API,和通过Token租赁平台(中转)调用,价格能差出不少。
一、Token租赁是什么?和直接调API有什么区别?
Token租赁,说白了就是平台先批量采购大模型的API额度,再转售给终端用户。类似批发转零售。
这样做的好处:
- 价格更低。平台能拿到批发折扣,转售价格通常比官方零售价低20%-50%。
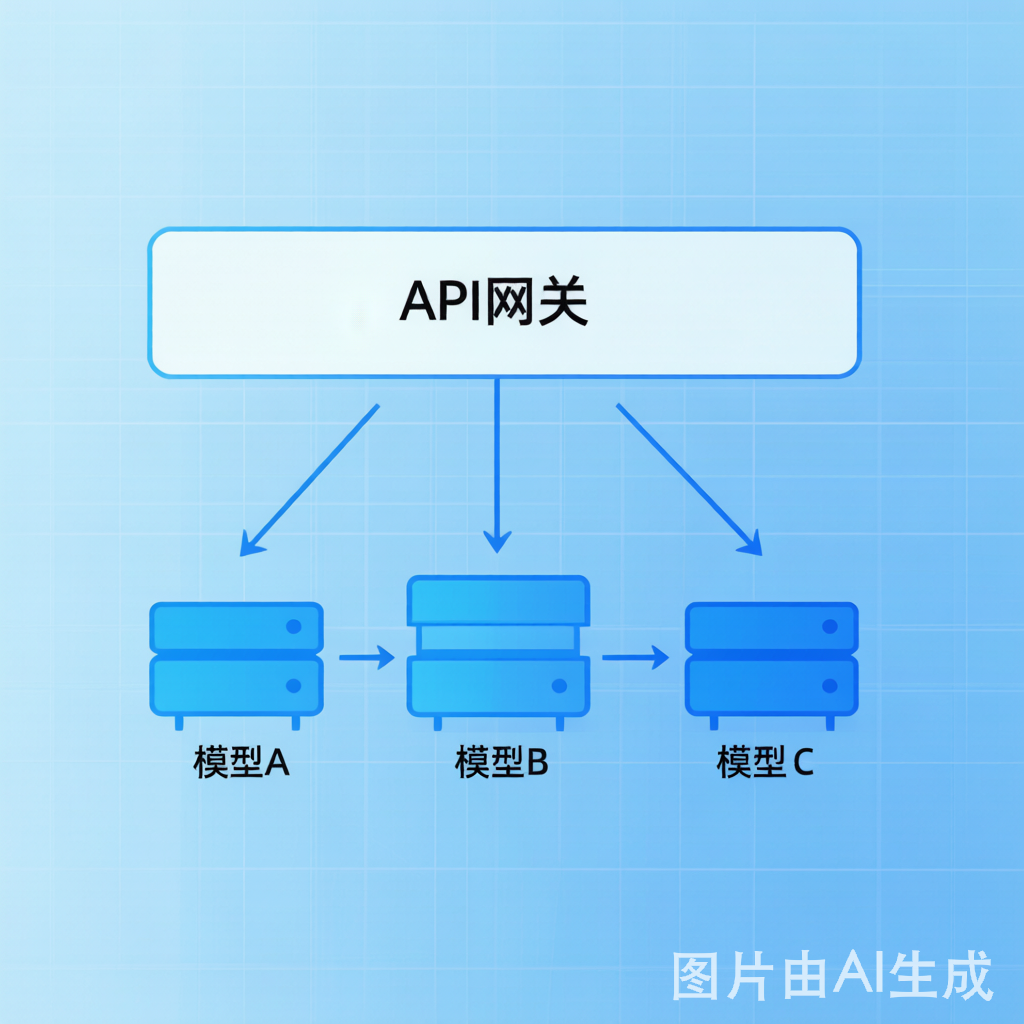
- 一个平台调用所有模型。不用在DeepSeek、OpenAI、Claude之间来回切API Key,一个接口搞定。
- 按量计费更灵活。官方API往往有最低充值门槛,Token租赁平台可以按实际用量精确计费,甚至按次付费。
举个例子:DeepSeek-V3官方API输入价格1元/百万Token,通过Token租赁平台可能只要0.7-0.8元。如果你的应用日调用量在百万Token级别,一年下来能省几千到上万元。
二、2026年主流大模型API价格一览
以下价格来自各厂商官方定价及TokenHub等平台2026年6月汇总数据(单位:元/百万Token):
国产模型:
DeepSeek-V3:输入1元,输出2元,上下文64K
DeepSeek-R1:输入2元,输出8元,上下文128K
Qwen-Turbo(通义千问):输入0.3元,输出0.6元,上下文32K
Qwen-Plus:输入2元,输出6元,上下文128K
Qwen-Max:输入10元,输出20元,上下文32K
Doubao-Pro-32K(豆包):输入0.8元,输出2元,上下文32K
Doubao-1.5-Pro:输入5元,输出9元,上下文256K
ERNIE-Speed(文心):输入0.6元,输出0.6元,上下文8K
ERNIE-4.5(文心):输入4元,输出8元,上下文200K
GLM-4-Flash(智谱):完全免费,上下文128K
GLM-4-Air:输入0.5元,输出0.5元,上下文128K
海外模型(通过中转平台的价格通常比官方低15%-30%):
GPT-4o:输入约15-18元,输出约60-70元(官方价更高)
Claude Sonnet 4:输入约20-25元,输出约80-100元
Gemini 2.0 Flash:输入约1-2元,输出约4-8元
三、不同场景怎么选模型?
做对话机器人/客服
选Qwen-Turbo或GLM-4-Flash。前者百万Token只要0.3元,后者免费。日常对话场景这两个模型的回答质量完全够用。
写代码/技术问答
选DeepSeek-V3或DeepSeek-R1。V3适合日常编程辅助,R1的推理能力强,复杂逻辑和数学题更靠谱。V3输入1元/百万Token的价格是目前性价比最高的选择之一。
长文本分析(合同审阅、论文总结)
选Doubao-1.5-Pro或ERNIE-4.5。这两个都支持200K以上上下文窗口,能一口气处理几十万字的文档。
追求最高质量(需要推理深度)
选Claude Sonnet 4或GPT-4o。价格贵但回答质量确实高一档。建议只在核心场景用,日常任务切到国产模型省钱。
预算极度有限
选GLM-4-Flash(免费)+ Qwen-Turbo(0.3元/百万Token)组合。前者处理简单对话,后者处理需要一定质量的场景。
四、Token租赁平台怎么选?
看几个关键指标:
第一,价格是否真的比官方低。有些平台打着"低价"的旗号,实际加了服务费后比官方还贵。下单前自己算一下。
第二,支持的模型是否全。DeepSeek、通义千问、文心、豆包、GPT、Claude——你需要的模型都得有。别租了之后发现少一个关键模型。
第三,有没有缓存计费。大部分模型对重复Prompt有缓存折扣(通常打五折),好的平台会把这个优惠传给你。
第四,计费粒度。是按次还是按Token精确计费?最低充值多少?有没有过期清零的坑?
第五,稳定性。API中转最大的风险是服务中断。选有SLA保障的平台,别图便宜选个人搭建的"野鸡中转"。
五、一个省钱技巧:模型分层调用
不是什么请求都需要最贵的模型。
我见过一个很聪明的做法:设置一个路由层,简单问题走Qwen-Turbo(0.3元),复杂问题走DeepSeek-R1(2-8元),只有极少数需要最强推理的请求才走GPT-4o(15-60元)。最终综合成本比全用GPT-4o低了80%以上。
类似的,长文本场景可以先用便宜的模型做摘要提取,再把摘要送进贵的模型做深度分析。
Token租赁正在变成AI应用的基础设施。不是因为它多高大上,而是因为它实实在在地让调用大模型的成本降下来了。对于每天调用量在十万到百万Token级别的中小团队来说,省下的不是小钱。