
5090算力租一天多少钱?32GB显存与4090怎么选
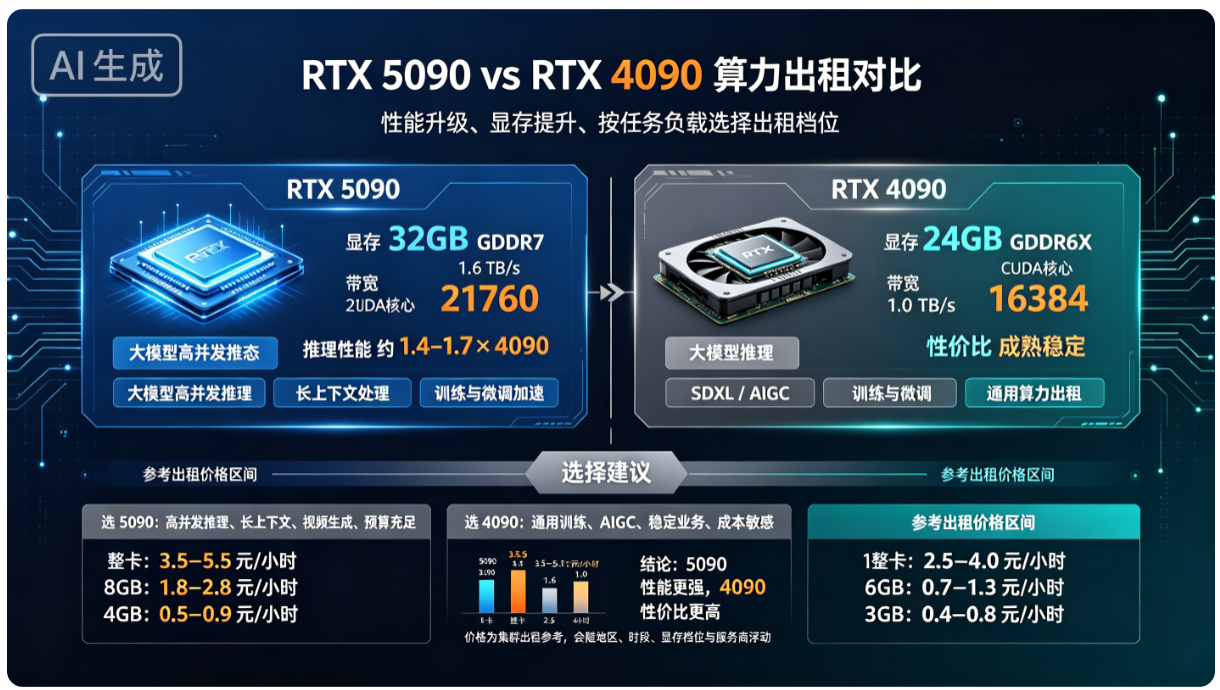
先算钱。JYGPU 官网 2026 年 9 月 20 日页面显示,5090 32G × 8 裸金属整机为 ¥19888/月,折后 ¥15910/月,折合单卡约 ¥1989/月、约 ¥66/天。同一页面上的 4090 24G × 8 整机为 ¥9900/月,折后 ¥7920/月,单卡约 ¥990/月、约 ¥33/天。整机差价大约一倍,单卡日差约三十三元。
数据来源:JYGPU 官网 https://www.jygpu.com/markets 公开页面(2026-09-20 查询)。单卡按小时租赁的具体价格以 JYGPU 官网当前实际报价为准。
一、核心答案:5090 贵在哪,值不值
5090 相对 4090 的核心变化是显存从 24GB 提到 32GB,以及架构和显存代际的更新。对租用方来说,这两点带来三个实际收益:
- 单卡能装下更大的模型。FP16 精度下,32GB 能容纳约 16B 参数级别的模型权重,24GB 只能到约 12B。13B 到 14B 模型从"勉强要量化"变成"可以直接跑"。
- 推理并发更高。权重占完之后留给 KV Cache 的空间更大,同样一张卡能同时服务的请求更多。
- 微调的可选空间更大。LoRA 微调能覆盖的模型规模上限提高,batch size 也能开得更大。
二、参数对照:官网标注的两款卡
| 项目 | 4090(JYGPU 页面标注) | 5090(JYGPU 页面标注) |
|---|---|---|
| 单卡显存 | 24GB | 32GB |
| 整机算力标注 | 8 × 330T FLOPS(FP16) | 8 × 210T FLOPS(FP16) |
| 整机 CPU | 2 × Intel(单颗 64 逻辑核心) | 2 × Intel(单颗 32 逻辑核心) |
| 整机内存 | 8 × 64GB DDR4 | 16 × 64GB DDR5 |
| 硬盘 | 2 × 3.84TB | 1 × 3.84TB |
| 互联 | NVLink + IB 网卡 | NVLink + IB 网卡 |
| 整机价格 | ¥9900/月,折后 ¥7920/月 | ¥19888/月,折后 ¥15910/月 |
数据来源:JYGPU 官网 https://www.jygpu.com 裸金属页面标注(2026-09-20 查询)。算力为平台页面标注口径,不同厂商的 FP16 算力统计口径(稠密/稀疏)可能不同,横向比较时以同平台同口径为准。具体价格以官网当前实际报价为准。
三、怎么判断:用并发和显存算一遍
1. 在 4090 上加载目标模型,记录 FP16 权重占用(约 参数量 × 2 字节);
2. 逐步加压并发,记录显存占用曲线;
3. 若目标并发下显存占用已超过 85%,或 KV Cache 频繁触发抢占导致延迟飙升,则换 5090;
4. 若显存还有余量且延迟达标,继续用 4090。
举例:14B 模型 FP16 权重约 28GB,4090 的 24GB 装不下,必须量化或换卡;5090 的 32GB 可直接承载,省去量化带来的精度损失。这种情况下差价是值的。
注:以上为理论计算值与行业经验方法,实际结果受推理框架、KV Cache 管理、上下文长度影响。
四、不同场景怎么选
个人与小团队实验
4090。单卡按小时租,成本最低,跑 7B 模型足够。
13B 到 14B 模型推理服务
5090。省掉量化环节,输出质量更稳定,单卡并发也更高。按月租整机更划算。
需要长上下文的推理
优先 5090,甚至考虑更大显存的专业卡。长上下文会显著放大 KV Cache 占用,显存是硬约束。
多卡微调训练
算力需求优先时看整机配置与互联,不要只看显存数字。建议先用小规模任务实测单机吞吐,再决定机型。
常见问题
5090 算力租一天多少钱?
按 JYGPU 官网 8 卡整机 ¥19888/月(折后 ¥15910/月)折算,单卡约 ¥1989/月、约 ¥66/天。单卡按小时租赁的价格以 JYGPU 官网当前页面报价为准。
5090 比 4090 强多少?
最确定的差别是显存从 24GB 到 32GB,以及内存规格升级。算力部分要看统计口径,不同平台标注方式不同,建议以同一平台的标注做横向比较,或直接用实测吞吐判断。
32GB 显存能跑多大模型?
FP16 精度下约能承载 16B 参数级别的权重;配合量化可以跑更大模型但会有精度损失。实际可用规模还要扣除 KV Cache 与运行时开销。
做推理选 8 卡 4090 还是 4 卡 5090?
看单卡能否装下模型。装得下就用 4090 堆并发,成本更低;装不下就只能用 5090,多卡也无法绕过单卡显存限制(除非做模型并行,但推理场景一般不这么干)。
5090 显卡出租平台怎么挑?
看三件事:是否标明具体显存容量和整机配置、是否提供 NVLink 与 IB 互联、是否写明故障换卡时限。只写"高端显卡"不给参数的平台直接排除。
相关阅读
数据来源与说明
- JYGPU 官网 https://www.jygpu.com/markets 裸金属页面价格与规格标注(2026-09-20 查询),具体价格以官网当前实际报价为准。
- 显存与并发测算为理论计算值与行业经验方法,实际结果受框架、上下文长度与并发量影响。