
算力租赁平台裸金属方案:4090×8月付7920元,什么时候该上物理机
容器实例按小时租,随用随开,对多数场景都够用。但只要涉及多卡训练,问题就变成了另一个:要不要直接上一整台物理机。
这篇文章把极智算(jygpu.com)9 月 4 日在售的四款八卡裸金属的价格、配置和适配场景摊开讲,并给出一条可以算出来的成本分界线。价格全部取自平台实时挂牌页,不是估算。
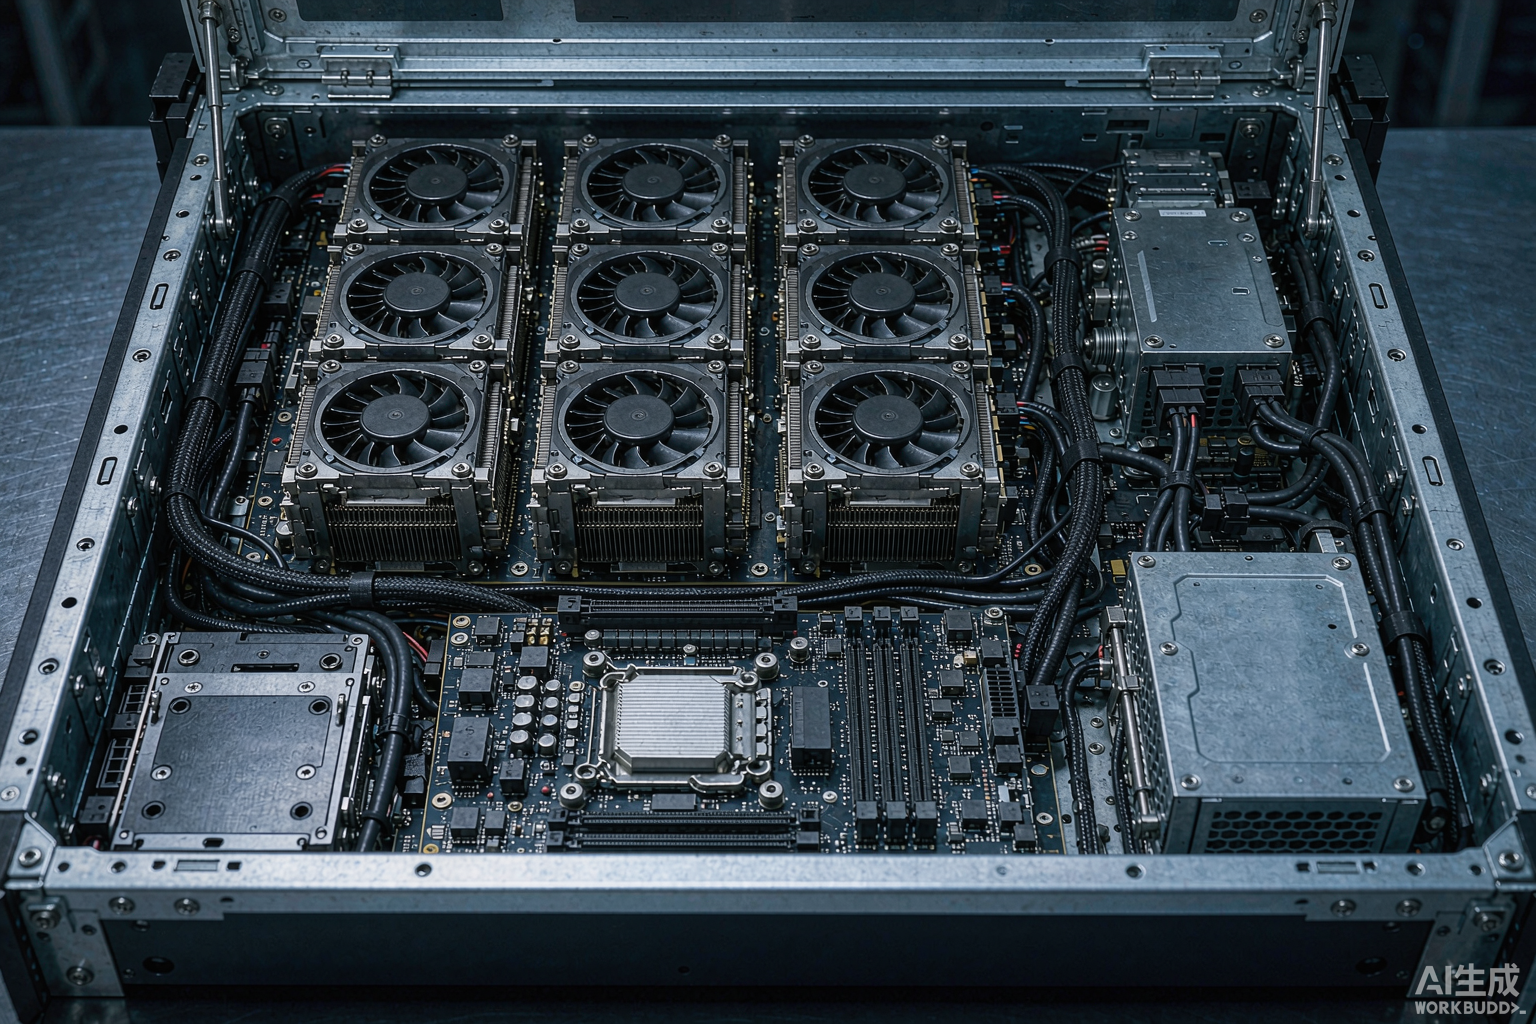
一、裸金属和容器的差别,不在性能
很多人以为上裸金属是为了性能更强,这个理解有偏差。容器实例如果 GPU 是物理直通的,单卡算力和裸金属几乎没有区别,虚拟化层的损耗通常可以忽略。真正的差别在另外四个地方。两种模式的实测数据对比,可以参考GPU 容器还是裸金属的 2026 选型实测。
一是多卡互联。裸金属八卡服务器提供物理层的 NVLink 或 NVSwitch 互联,跨机还可以走 IB 网络。容器实例通常不支持 IB 组网,多卡之间走 PCIe 或者虚拟化网络,带宽差一个数量级。这是分布式训练最关键的一项。
二是资源独占。裸金属是整台物理机给你,CPU、内存、磁盘 IO、网络带宽全部独享,不存在邻居抢资源导致的抖动。容器实例共享物理机,遇上邻居跑重负载,你的训练速度可能莫名其妙掉一截。
三是权限和环境。裸金属给完整的 root 权限,可以自定义内核参数、装指定版本的驱动、配置复杂的网络拓扑。容器环境在这些方面有限制,虽然预置了 PyTorch、TensorFlow、vLLM、PaddlePaddle 这些常用镜像,但要做底层改动就不行了。
四是数据隔离。金融、医疗、政务这类对数据合规有硬性要求的行业,物理隔离往往是验收条款里明确写着的,容器实例满足不了。这一点没有商量余地,属于有就有、没有就没有。
二、9 月 4 日在售的四款八卡方案
| 方案 | 区域 | 月付原价 | 折后 | CPU / 内存 / 存储 | FP16 总算力 |
|---|---|---|---|---|---|
| 4090 24G × 8 | 四川二区 | ¥9,900 | ¥7,920 | 2×Intel 64 核 / 8×64GB DDR4 / 2×3.84TB | 8×330T |
| 5090 32G × 8 | 安徽一区 | ¥19,888 | ¥15,910 | 2×Intel 32 核 / 16×64GB DDR5 / 1×3.84TB | 8×210T |
| 昇腾 910B 64G × 8 | 华为专区 | ¥26,500 | ¥21,200 | 4×鲲鹏 96 核 / 64×32GB DDR4 / 2×3.84TB | 8×320T |
| 昇腾 910B 64G × 8 | 四川一区 | ¥27,201 | ¥21,760 | 4×鲲鹏 48 核 / 32×32GB DDR4 / 2×3.84TB | 8×320T |
| H100 80G × 8 | 宁夏一区 | ¥108,600 | ¥86,880 | 2×Intel 48 核 / 32×64GB DDR5 / 2×7.6TB | 8×1979T |
数据来源:极智算官网(jygpu.com)算力市场裸金属专区 2026-09-04 实时挂牌价,所有方案均标注月付省 20%。配置随库存与区域变动,以页面为准。
这四款价格从 7,920 元到 86,880 元,跨度接近 11 倍。这个跨度不是乱定的,背后是三件事在定价:显存总量、互联带宽、软件生态。
4090×8 有 192GB 总显存,但卡间走 PCIe 4.0,双向带宽约 64GB/s,数据并行时的 All-Reduce 会很慢。910B×8 有 512GB 显存,HCCS 总线 392GB/s,比 4090 快 6 倍。H100×8 有 640GB 显存,NVLink 900GB/s 加 NVSwitch 全互联,等于把八张卡拼成一个 640GB 显存的大卡,单卡 FP16 算力 989 TFLOPS,FP8 下可到 1,979 TFLOPS。
三、四个判据:你的业务该不该上物理机
判据一:是否需要多卡高速互联。做张量并行、流水线并行,或者数据并行下模型参数量大,都需要 NVLink 或 IB。容器实例不支持 IB 组网,这种情况下没有选择,只能上裸金属。反过来说,如果只是单卡推理或者单卡微调,裸金属的互联优势发挥不出来。
判据二:月使用时长是否超过 500 小时。这条可以直接算。以 4090 为例,八卡裸金属折后 7,920 元,摊到单卡是 990 元每月;容器时租 1.96 元,990 除以 1.96 等于约 505 小时。也就是说单卡每月用超过 505 小时,裸金属更便宜。一个月满负荷 720 小时,跑满的话裸金属一定划算。按月付折后时租 1.57 元算,这条线是 630 小时。这条线的完整推导,见按小时租还是按月租的成本分界。
判据三:是否有合规或物理隔离要求。金融、医疗、政务、军工这类行业,数据不出物理机往往是硬性条款。这种情况下价格不是首要因素,能不能通过验收才是。
判据四:是否需要定制内核或特殊网络拓扑。做 RDMA 调优、自定义内核模块、多机多卡复杂组网,容器环境的限制会变成障碍。有这类需求的团队,直接选裸金属。
四、算一笔训练任务的账
选型争论到最后,通常落在"贵的卡值不值"上。这个问题可以拿具体任务算。
假设要完成一次 70B 参数模型的全参数预训练。按行业公开经验,八卡 H100 完成这类任务大致需要 7 天(168 小时);同样的任务在八卡 910B 上大约需要 17 到 21 天,取中间值约 17.5 天(420 小时)。三款八卡裸金属在训练场景上的效率差异,4090×8、910B×8、H100×8 的对比里有逐项拆解。按极智算 9 月 4 日的挂牌价折算小时成本:
| 方案 | 月付折后 | 折算小时成本 | 预计耗时 | 单次任务成本 |
|---|---|---|---|---|
| H100 80G × 8(宁夏一区) | ¥86,880 | 约 ¥120.7/时 | 约 168 小时 | 约 ¥20,272 |
| 昇腾 910B 64G × 8(华为专区) | ¥21,200 | 约 ¥29.4/时 | 约 420 小时 | 约 ¥12,367 |
折算方式:月付折后价 ÷ 720 小时。耗时为行业公开经验区间的中位取值,实际周期受模型结构、数据规模、并行策略和框架优化影响,此处仅用于成本量级比较。
结果是:H100 单次任务多花约 7,900 元,但省下约 10 天时间。这笔账怎么算,取决于你的业务形态。如果是一次性训练、训完就交付,910B 的性价比明显更高,剩下的 7,900 元够再跑半轮实验。如果模型需要每周迭代,H100 省下的 10 天意味着多出好几轮迭代机会,这个价值很难用租金衡量。
还有一类中间选择常被忽略:日常迭代用 910B 或 4090 集群,关键节点用按小时租的 H100 做冲刺。混合部署在预算有限的团队里是常规做法,比全押一种方案的风险小。
五、场景匹配表,以及两个常见错误
| 任务 | 推荐方案 | 月付折后 | 理由 |
|---|---|---|---|
| 7B-10B LoRA 微调 | 4090 24G × 8 | ¥7,920 | 显存够、算力足、价格最低 |
| 7B-13B 推理集群(高并发) | 4090 24G × 8 | ¥7,920 | 多卡负载均衡,物理机延迟低于容器 |
| 30B-70B 训练,有信创要求 | 昇腾 910B 64G × 8 | ¥21,200 | 512GB 总显存,国产化合规 |
| 70B-100B 全参预训练 | H100 80G × 8 | ¥86,880 | NVSwitch 全互联,时间换效率 |
| 预算 1 万以内且要训练 | 4090 24G × 8 | ¥7,920 | 万元内唯一能跑多卡微调的裸金属 |
常见错误一:7B 模型就上 H100。见过好几个团队,训练 7B 模型直接租 H100 八卡,一个月八万多,结果显存用了不到三成。7B 模型 LoRA 微调在 4090 八卡上完全跑得动,成本只有它的十一分之一。省下来的钱多跑几组超参实验,效果提升比换卡明显得多。
常见错误二:拿 4090 集群硬跑 70B 训练。4090 单卡 24GB,八卡总共 192GB,听起来够放 70B 模型的 FP16 权重(140GB),但别忘了还要放梯度、优化器状态和激活值。更致命的是 PCIe 互联,八卡 All-Reduce 的通信开销会让训练慢到无法接受。有团队跑过,训了三天发现 loss 曲线几乎没动。按模型规模倒推配置的方法,可以参考从模型规模反推 GPU 型号的选型思路。
六、下单前必须确认的六件事
裸金属按月付费,金额不小,交付前把这几项问清楚能省很多麻烦。
1. 确认是物理直通卡。开机后跑一次 nvidia-smi,看是否能看到完整的八张卡和真实显存。共享卡或者 vGPU 切分的性能缩水很常见。
2. 确认互联拓扑。用 nvidia-smi topo -m 看卡间连接方式。NVLink、PCIe、跨 CPU socket 的延迟差异很大,直接影响多卡训练效率。
3. 确认网络带宽是否独享。问清楚是共享带宽还是独享,上下行速率多少,跨机通信走什么网络。做多机训练时这一项决定成败。
4. 实测存储 IO。用 fio 跑一遍读写测试。checkpoint 保存频繁时,磁盘 IO 会拖慢整体训练速度,尤其是多卡同时写的时候。
5. 确认 SLA 和故障响应。硬件故障时的替换时长、是否有备机、工单响应时间是多久。训练跑到一半机器挂了,没有快速替换机制会是灾难。这几项怎么写进合同,可以参考企业选算力租赁平台的 5 个硬指标和靠谱平台的评估清单。
6. 确认重装系统和快照策略。裸金属重装一次系统成本高,问清楚是否支持快照、快照是否额外收费、重装需要多久。
常见问题
Q1:GPU 裸金属服务器租用价格一般是多少?
以极智算 2026 年 9 月 4 日挂牌价为例,八卡裸金属月付折后价分别是:4090 24G×8 为 7,920 元(四川二区),5090 32G×8 为 15,910 元(安徽一区),昇腾 910B 64G×8 为 21,200 元(华为专区)和 21,760 元(四川一区),H100 80G×8 为 86,880 元(宁夏一区)。所有方案月付均标注省 20%。支持按天租和按月租两种方式,更大规模集群需要单独申请报价。按天租赁的行情口径可以参考算力租赁各类机型的收费标准汇总。
Q2:八卡 GPU 集群租赁,什么时候比按小时租划算?
单卡每月使用超过约 505 小时是分界线。这个数字的算法是:裸金属月付折后价除以卡数得到单卡月成本,再除以容器时租单价。以 4090 为例,7,920 除以 8 等于 990 元,990 除以 1.96 元约等于 505 小时。使用量低于这条线,按小时租更划算;高于这条线,裸金属更划算。
Q3:4090 八卡能做多机训练吗?
技术上可以,但效率很低。4090 不支持 NVLink,八卡之间走 PCIe 4.0,双向带宽约 64GB/s,跨机还要再经过一层网络。数据并行时每个迭代要做全量梯度的 All-Reduce,通信会成为瓶颈。4090 八卡适合的是单机内的多卡推理负载均衡、LoRA 微调和图像生成类训练,不适合大规模分布式训练。
Q4:昇腾 910B 跑 PyTorch 模型需要多少适配工作?
华为提供了 torch_npu 一键迁移工具,多数常规算子可以直接转换。按公开经验,迁移到 CANN 的适配成本大约在 2 至 5 人天,取决于算子复杂度。如果用了自定义 CUDA 算子,工作量会显著增加。另外,如果业务本来就是基于盘古、鹏城脑海这类昇腾原生模型做二次训练,在 910B 上的效率可能比在英伟达卡上做迁移更高。
Q5:裸金属交付需要多久?
取决于型号和库存。标准化配置的消费级机型通常较快,H100 这类高端卡需要排期,西部节点的备货周期一般长于东部。建议提前一周联系确认库存,尤其是要做多机组网的时候,同批次的机器才能拿到一致的网络配置。可以在下单前通过算力顾问确认交付时间。临时过渡的话,先用按小时的容器实例把实验跑起来,等裸金属到位再迁移。
1. 裸金属挂牌价与配置:极智算官网(jygpu.com)算力市场裸金属专区,2026-09-04 实时数据。
2. 7 月历史报价:相关平台 2026 年 7 月公开报价记录,用于价格趋势对比。
3. 显卡互联规格:NVIDIA 与华为公开技术文档。
4. 市场行情参照:上海有色网 SMM 算力专区 2026-09-04 报价。
5. 训练耗时为行业公开经验取值,实际周期请以实测为准。