
中小企业GPU租赁速查手册:选型、预算与避坑10分钟决策版
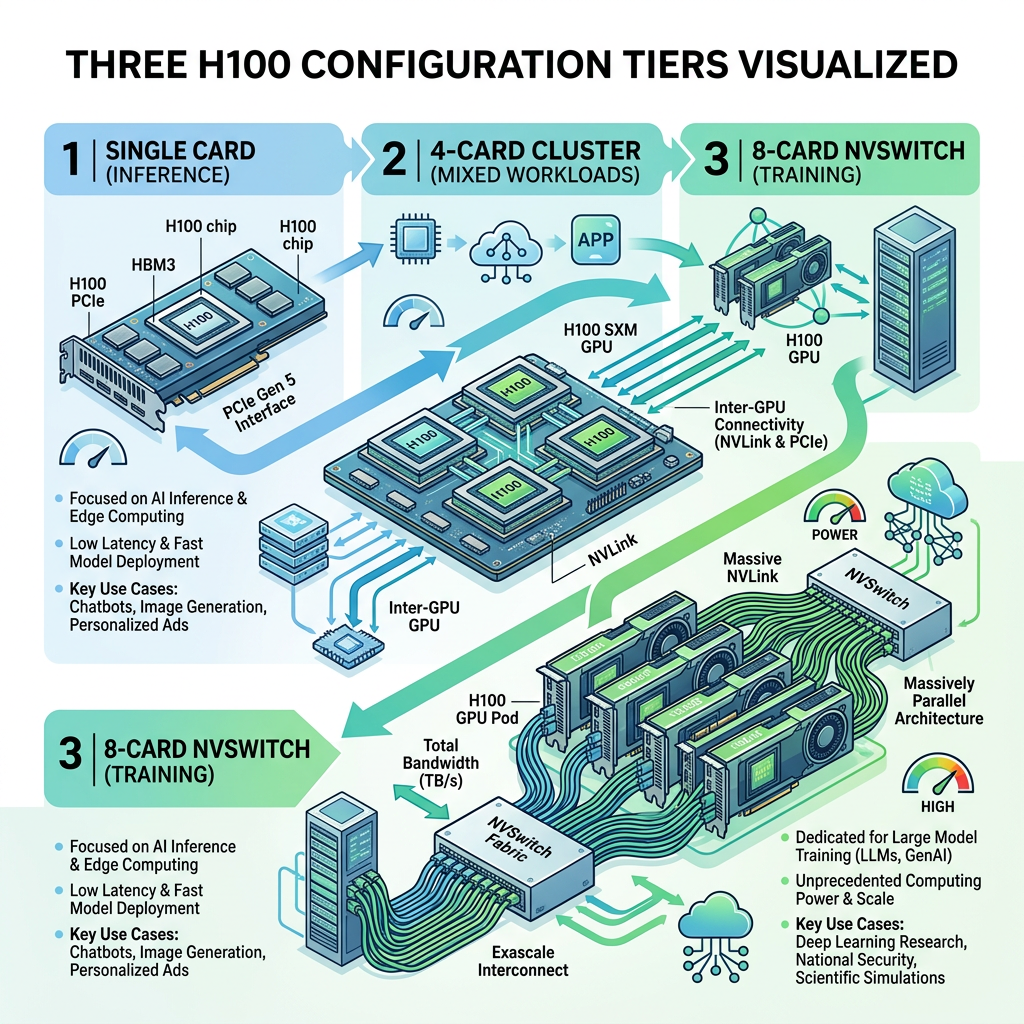
一、中小企业租GPU的三个典型场景
中小企业和大厂的区别不只是预算多少,更关键的是:需求变化快、团队在成长、没有专职运维。所以我们按企业所处阶段,拆成三条路径来讨论。
路径A:验证期(团队<10人,月预算<1万元)
典型画像:AI创业公司还在POC阶段,需要快速验证模型可行性。团队以算法工程师为主,没有运维人员。
推荐方案:租1-4张RTX 4090,按小时计费。单卡月费1,200-1,800元,4卡约5,000-7,000元/月。不需要最小租期、不需要预付。
关键技术点:4090足够覆盖7B-13B模型的微调/LoRA和推理。如果需要多卡训练,确认平台是否支持多张4090通过PCIe互联(效率比NVLink低但可用)。
预算红线:GPU月支出不超过1万元,留出预算给数据集存储和推理API调用。
路径B:成长期(团队10-50人,月预算1-5万元)
典型画像:产品已有MVP,开始规模化训练和部署推理服务。同时跑2-3个模型方向。
推荐方案:混合部署——2-4张H20做推理(月租2-6万),4-8张4090做训练(月租5,000-1.4万)。总月费控制在3-5万元。
关键技术点:H20有大显存(96GB),能单卡跑70B模型推理,比H100在推理场景性价比更高。同时H20是合规版本,不受出口管制影响。
性价比建议:这个阶段不建议租H100集群——月费40-50万在成长期性价比不高。用H20+4090的混合方案,能覆盖90%的需求。
路径C:规模期(团队50+人,月预算>5万元)
典型画像:有稳定产品线,需要持续训练大模型或多条产品线共用算力。开始有专职运维或DevOps。
推荐方案:裸金属H100×8集群做训练(月租40-50万/集群),推理用H20/A100池(月租另计)。整体GPU预算20万+/月。
关键技术点:这个阶段必须要求InfiniBand或至少RoCE v2组网。25GbE在多节点训练时通信开销过大会吞掉近半算力。
管理建议:建立GPU利用率监控体系,月均利用率<60%需要重新评估是否需要裸金属集群,也许多租几张单卡比整租集群更灵活。
二、中小企业的四个常见坑
三、中小企业GPU租赁快速决策流程
| 决策步骤 | 操作 | 耗时 |
|---|---|---|
| 1. 定需求 | 模型参数量?训练还是推理?预计月卡时? | 30分钟 |
| 2. 选GPU | 对照本文三条路径,确定型号和数量 | 10分钟 |
| 3. 估预算 | GPU租金+网络+存储+附加费用=全口径月费 | 15分钟 |
| 4. 选平台 | 筛选3家有B11资质、支持对公转账的平台 | 1小时 |
| 5. 试水 | 先租1张卡跑3天,验证体验 | 3天 |
| 6. 签合同 | 月付/季付起步,SLA+数据条款确认 | 1天 |
四、月预算速查表
| GPU方案 | 数量 | GPU月费 | 附加费用 | 全口径月费 | 适用阶段 |
|---|---|---|---|---|---|
| RTX 4090单卡 | 1张 | 1,200-1,800元 | 200-400元 | 1,400-2,200元 | 验证期、个人开发 |
| RTX 4090×4 | 4张 | 4,800-7,200元 | 500-1,000元 | 5,300-8,200元 | 验证期、小团队训练 |
| H20×2 + 4090×4 | 6张 | 27,000-44,000元 | 1,500-3,000元 | 28,500-47,000元 | 成长期 |
| H100×8裸金属 | 8张 | 400,000-520,000元 | 10,000-20,000元 | 410,000-540,000元 | 规模期(大模型训练) |
实际价格以官网实时价格为准。附加费用按经验占比估算,具体以平台报价为准。
五、FAQ
Q1:创业公司预算紧,必须自己租GPU吗?有没有更便宜的替代方案?
如果只是做推理和API调用,直接用模型API服务(按token付费)可能比租GPU更划算。但如果需要微调模型、做定制化训练,租GPU是成本最低的方案。按小时租4090做一次LoRA微调,总成本通常在50-200元,比买一张4090(约1.5万元)低两个数量级。
Q2:小团队没有运维,GPU租赁平台的技术支持靠谱吗?
正规企业级平台通常提供基础技术支持(环境部署、驱动更新、常见故障排查)。但深度模型调优通常不在基础支持范围内。建议:选择提供预装深度学习环境的容器平台(已配好PyTorch/TensorFlow/CUDA),省去环境配置时间。
Q3:我们是做CV的,和做大模型的团队选卡有什么不同?
CV任务对显存的需求通常低于大模型训练。推理场景以7B-13B模型为主,RTX 4090或A100 40GB足够。如果涉及大batch size或多任务并行,优先考虑大显存卡。CV训练对多卡互联的需求也比LLM训练低,PCIe互联通常足够。
Q4:团队从4090升级到H100/H20的最佳时机是什么?
三个信号:①你的模型参数量长期>30B,4090单卡跑不动;②训练耗时成为产品迭代瓶颈,你愿意为缩短训练时间付费;③有付费客户或投资到账,可以支撑更高算力投入。在这之前,4090是最优解。
Q5:GPU租赁可以走创业孵化器的优惠吗?
部分平台有针对创业公司的扶持计划,比如首月折扣、免费试用额度、技术指导等。建议直接咨询平台是否有创业扶持政策,或在入驻孵化器/加速器时留意合作算力平台的资源包。多问一句不会亏。
六、中小企业GPU租赁决策清单
- 模型类型和参数量已确认
- 训练/推理比例和月卡时已估算
- 对照三条路径(验证期/成长期/规模期)确定了对应方案
- 全口径月预算已评估(含网络、存储、附加费)
- 已筛选至少2家具备B11资质的平台
- 已完成1-3天小规模试用测试
- 合同条款中"SLA赔偿是赔钱"、"数据归属、删除流程"已确认
- 已保留备用平台账号以备切换
- 团队内已指定GPU使用和关停的负责人
总结
中小企业租GPU的核心原则就三条:从4090起步、用混合方案、别锁死一家平台。
4090是小团队的最佳入门卡——1,200-1,800元/月,覆盖绝大多数验证期和成长期需求。H100集群是规模期的选择,不是起步标配。混合方案(4090训练+H20推理)是成长期性价比最高的组合。多平台策略不是大厂专利,小团队更需要避免供应商单点故障。
GPU租赁的门槛已经很低了——按小时计费、分钟级开通、无需押金。先用起来,边跑边调。比起花三个月做自建方案比价,先租一周把模型跑通,可能是更务实的开始。
实际价格以官网实时价格为准。查看GPU算力租赁实时报价 →