
2026年算力租赁平台市场深度分析:供需失衡下的企业算力采购策略
2026年上半年,国内AI算力市场的热度超出了大多数行业观察者的预期。中国信通院2026年Q1数据显示,国内AI算力需求同比增长417%,供给增速仅为128%。这不是一个偶发的波动,而是大模型训练和推理需求两端同时膨胀之后,供应链结构性瓶颈被彻底暴露的结果。
对正在评估算力租赁平台的企业CTO和采购负责人来说,当前市场的核心矛盾已经不只是"选哪家",而是在需求持续跑赢供给的大背景下,如何制定一套既保证训练进度不延误、又不让成本失控的算力采购策略。
数据来源:中国信通院 2026年一季度报告
一、市场格局:供需缺口仍在扩大
1.1 GPU租赁价格半年内大幅上涨
根据SemiAnalysis发布的2026年Q1 GPU租赁指数,NVIDIA H100一年期租赁合同价格从2025年10月的每GPU每小时1.70美元上涨至2026年3月的2.35美元,涨幅接近40%。到2026年6月,H100的一年期合约和现货价格差距进一步拉大,短期需求集中释放时,现货价格一度突破3.00美元/小时。
H200和B200的情况更紧张。受台积电CoWoS先进封装产能制约——这道工序是H100/H200/B200三款芯片共同的瓶颈——微软、Meta、谷歌等超大规模云厂商已提前锁定了英伟达未来数年的工厂产能。对于独立云服务商和没有提前锁量锁价的中型企业,拿到H200甚至B200现货的窗口已经非常窄。
H100一年期租赁价格走势
| 时间节点 | 价格($/GPU/小时) | 变动幅度 |
|---|---|---|
| 2025年10月 | $1.70 | 基准 |
| 2026年3月 | $2.35 | +38.2% |
| 2026年6月(现货) | $3.00+ | +76.5% |
数据来源:SemiAnalysis GPU租赁指数(2026年H1)
1.2 市场规模:预计全年突破2600亿元
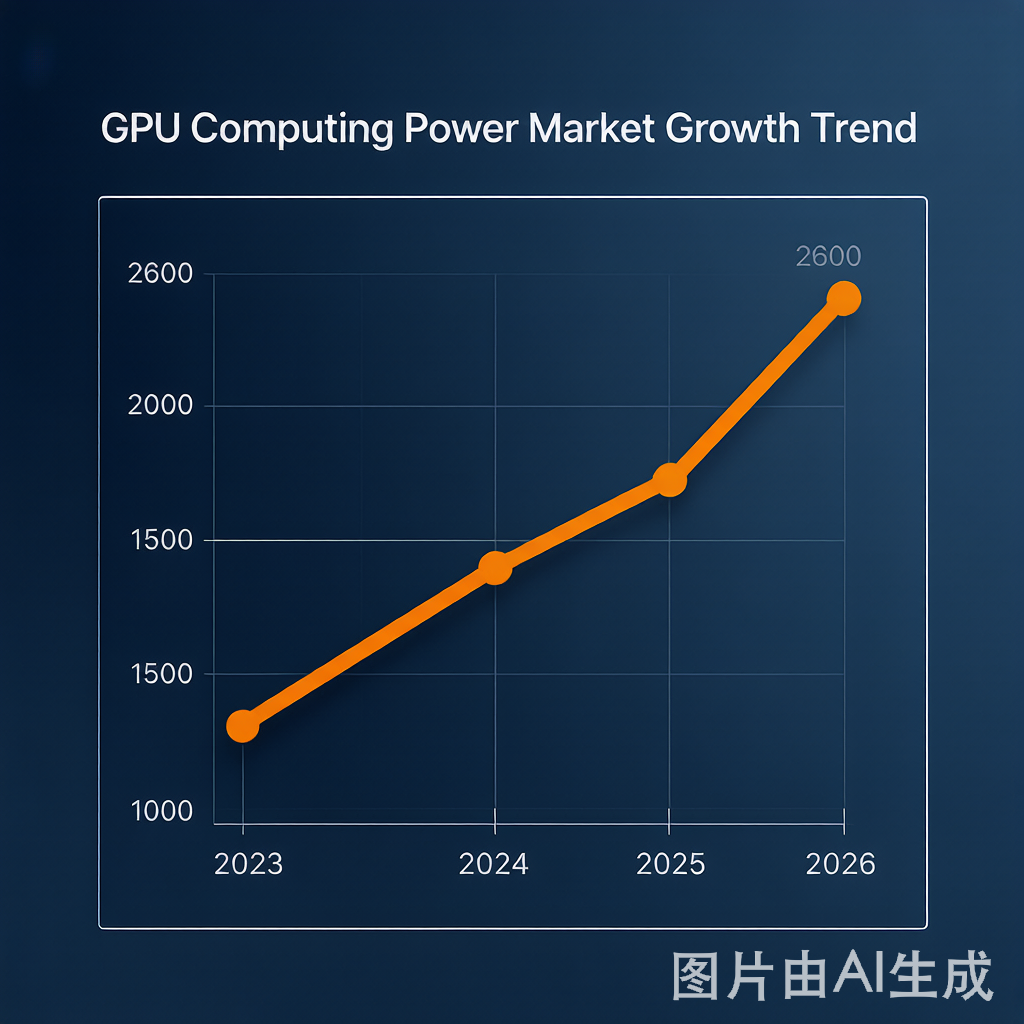
2026年Q1国内算力租赁市场规模达680亿元,同比增长62%。按照这一增速推算,全年市场规模有望突破2600亿元。需要注意的是,这还不包括企业自建算力中心的部分——如果加上私有化部署和信创采购,实际市场体量还要更大。
对于企业而言,这一数据背后的隐含信息是:算力已经成为一种紧缺资源,其采购逻辑正在从"按需采购的耗材"向"需要提前规划、锁量锁价的关键战略物资"转变。
二、供应链瓶颈:为什么算力一直紧缺
2.1 三大结构性因素同时收紧
GPU供应紧张的根源不在市场需求侧——恰恰相反,需求增长是可预期的。问题的核心在制造端,三大结构性因素正在同时收紧供应:
第一,CoWoS产能瓶颈。台积电的CoWoS先进封装产能已完全预订至2027年中。从H100到B200,所有主流AI GPU都依赖这道工序。即便NVIDIA持续向台积电追加产能订单,扩产节奏仍无法匹配需求增速。
第二,大厂优先锁量。微软、Meta、谷歌、亚马逊等超大规模云厂商已提前锁定英伟达数年的工厂产能。独立云服务商和中小企业在产能分配中处于明显劣势,能拿到的配额与真实需求之间存在显著缺口。
第三,推理需求爆发。SemiAnalysis数据显示,推理在AI算力中的占比已从2023年的33%增长至2026年的67%,市场规模约550亿美元,年增45%。H100从训练主力逐渐转为推理通用件,使用量实际上在持续增长——只是角色发生了变化。
2.2 算力并没有"过剩"
2026年6月,市场上有一种声音认为"算力过剩了",依据是部分GPU租赁价格出现了短期波动。这种判断经不起推敲。H100价格的短期回调反映的是上一代训练卡被集中释放和重新分配给推理场景,不是NVIDIA在大量扩产导致供给过剩。Q2末的价格企稳和Q3初的再次上涨已经验证了这一点。
对于正在选型的算力租赁平台用户,这个判断有直接的操作含义:不要期望"等一等价格就会降下来"。在可预见的时间窗口内(至少到2027年中CoWoS新产能释放前),算力价格保持高位运行的概率远大于大幅下降的概率。
三、对企业算力采购的影响
3.1 采购节奏必须前置
过去18个月,很多企业的习惯是"项目启动前一周去租卡"。这个节奏在2026年已经不适用了。当前市场的实际情况是:主流型号(特别是H100/H800系列)的现货池非常浅,临时需求很难得到及时响应。
建议的调整方向:
- 将算力采购纳入项目立项阶段的固定环节,而非执行阶段的临时需求。
- 与算力租赁平台建立长期合作框架,提前锁定3-6个月的GPU资源。
- 在多区域、多型号之间建立备选方案,单点依赖单一型号或单一区域的风险正在放大。
3.2 混合算力策略成为刚需
依赖单一GPU型号的算力策略在2026年的风险已经过高。更务实的做法是构建"高端+中端+国产"三层混合算力池:
- 高端层(H100/H200):用于大参数模型的核心训练阶段。
- 中端层(4090/A100):用于中小模型训练、微调和轻量推理。
- 国产层(昇腾910B/寒武纪):满足国产化要求,分散供应链风险。
3.3 推理成本正在成为新增变量
2026年推理算力占比超过67%这一数据有明确的采购含义:企业在规划算力预算时,不能只算训练成本。一个大模型上线后,推理算力的持续消耗往往被低估。以DeepSeek-V4为代表的大参数模型推理对显存和带宽的要求甚至超过了一些训练任务。建议在项目立项阶段就将训练和推理的算力需求一并评估,避免上线后出现"训练完了但跑不动推理"的尴尬局面。
四、算力租赁平台选型:2026年的关键评估维度
在供需持续紧张的市场环境中,算力租赁平台的选型标准也需要相应调整。以下五个维度是2026年企业评估算力供应商时的核心关注点:
4.1 GPU资源真实性
资源真实性是第一道门槛。2026年市场上出现了部分平台以"预售"名义收集订单但实际到货周期远超承诺的情况。验证方式包括:要求提供最近一周的可用资源清单、测试实际交付时效、确认是否有明确的SLA条款。
4.2 多区域交付能力
单一数据中心部署的风险在提升。如果全部GPU资源集中在某一个城市的某一个机房,一旦遇到区域性电力调控或网络故障,训练任务就会整体中断。建议优先选择至少在2个以上区域部署了可用资源的算力租赁平台。
4.3 交付形态灵活性
容器化算力和裸金属服务器的适用场景不同。同一个平台能否同时支持两种交付形态、能否在同平台内做资源切换,直接影响训练流程的连续性。这一点在裸金属集群训练场景中尤为关键——从容器环境做开发验证到裸金属环境做正式训练,如果能在一个平台内无缝切换,效率提升明显。
4.4 价格透明度
一个容易被忽视的指标是价格的稳定性。部分平台会以极低的"引流价"吸引首次下单,但在续租时大幅上调价格。建议在首次合作前明确询问续租价格机制和调价规则。
4.5 技术支持深度
B端用户与C端用户最大的区别在于:出问题时需要的是工程师层面的技术支持,而非客服层面的问题转达。对于大模型训练场景,环境配置、分布式通信故障、显存溢出等问题需要能直接与平台技术团队对接。评估时可以直接问一个问题:"训练过程中出现NCCL通信超时,你们的技术支持响应流程是什么?"
了解当前GPU资源实时价格,可以访问算力市场价格查询页面获取最新报价。
五、2026年下半年趋势预判
5.1 推理占比将继续上升
从训练到推理的算力重心转移已经是确定性趋势。2026年下半年,随着更多大模型从"研发训练阶段"进入"生产部署阶段",推理算力需求占比有望突破70%。这对算力平台的资源调度能力提出更高要求——推理场景的特点是并发高、延迟敏感、弹性需求强,与训练的批量、长周期特征完全不同。
5.2 B200将逐步渗透但不会立刻替代H100/H200
B200(Blackwell架构)已经开始交付,但受产能限制,2026年内的供应量仍然有限。大部分B200资源被超大规模云厂商自用或定向分配给特定战略客户,通过算力租赁平台公开可租的B200资源在2026年内不会形成规模。H200凭借141GB显存和4.8TB/s带宽的优势,在推理场景中将继续保持主力地位。
5.3 国产算力进入可生产验证阶段
华为昇腾910B在2026年上半年完成了几个关键的门槛跨越:千卡集群稳定性验证、主流框架适配度提升、以及多个商用模型的成功迁移。寒武纪、摩尔线程等厂商也在推进各自的生态建设。国产算力已经从"能不能用"进入"在哪些场景下性价比最优"的阶段。
六、总结与采购建议
2026年下半年企业算力采购三个核心建议
- 不要等价格回落。在CoWoS新产能于2027年中释放之前,算力价格维持高位的概率远大于下降。与其等待不如尽快锁量。
- 不要押注单一型号。构建H100/H200/4090/910B的多型号组合,避免被单一供应链波动卡住。
- 不要忽视推理成本。训练和推理的算力需求一并规划,避免"训练完但跑不动"的困局。
在当前这个算力供需比已经跌破3:1的市场中,决策速度本身就是一种竞争力。对于有明确AI研发计划的企业,尽快完成算力采购落地、将宝贵的时间和精力投入到模型迭代上,才是真正创造业务价值的方式。