
华为昇腾GPU服务器部署实践:从CANN环境配置到模型迁移全流程
把PyTorch代码从NVIDIA GPU迁移到华为昇腾,如果改几行import就能跑通,那是运气好。实际情况:大部分项目需要2-5个工作日的适配和调试。这篇文章记录了我们团队在极智算昇腾GPU服务器上完成部署的完整流程,包括每个环节的踩坑记录。
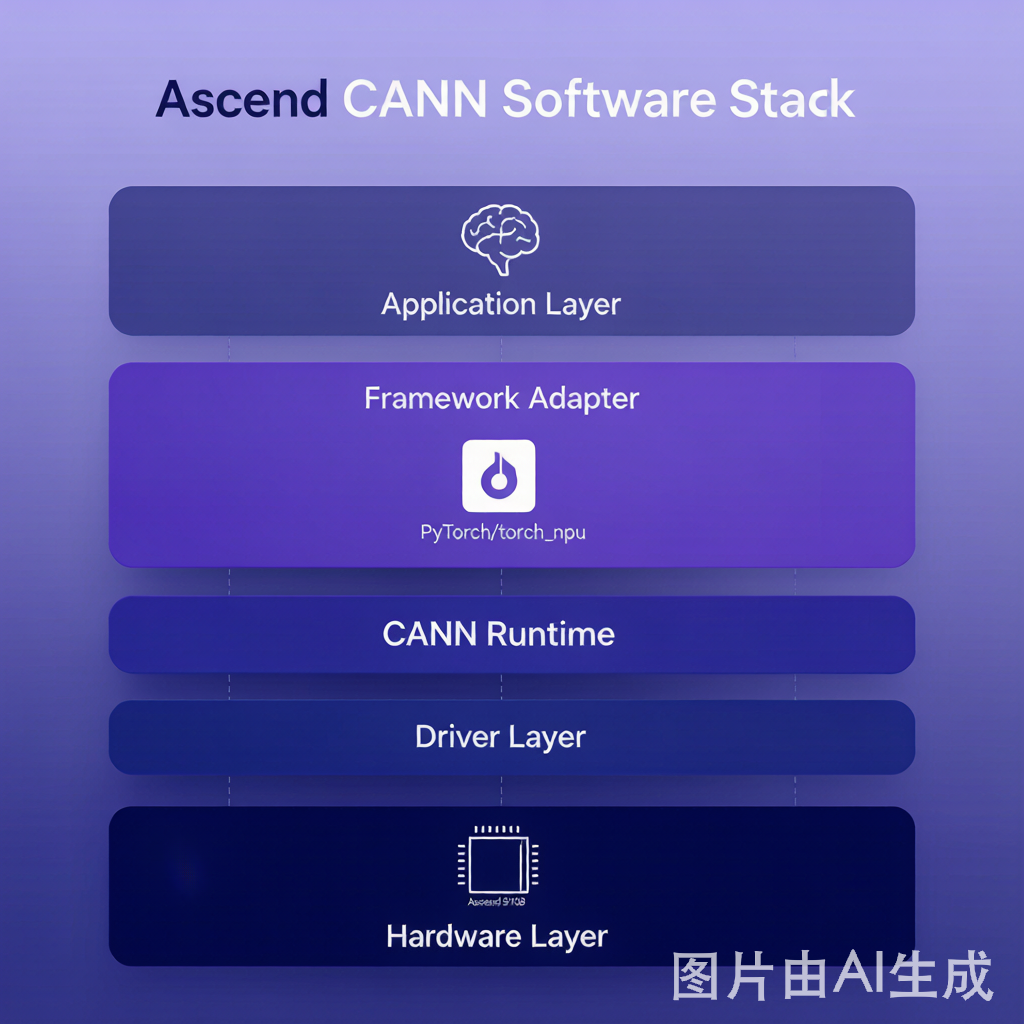
昇腾软件栈总览
动手之前,先理解昇腾的软件架构。它和NVIDIA CUDA生态的对应关系:
| NVIDIA生态 | 昇腾生态 | 说明 |
|---|---|---|
| CUDA Toolkit | CANN (Compute Architecture for NN) | 异构计算架构,包含驱动、运行时、编译器 |
| cuDNN | ACL (Ascend Computing Library) | 神经网络算子库 |
| NCCL | HCCL (Huawei Collective Communication Library) | 多卡通信库 |
| nvidia-smi | npu-smi | 设备管理工具 |
| PyTorch (CUDA) | torch_npu (PyTorch昇腾版) | 深度学习框架适配 |
| TensorRT | ATC (Ascend Tensor Compiler) | 模型编译优化工具 |
| NVIDIA Nsight | MindStudio / msprof | 性能分析工具 |
第一步:环境检查与驱动验证
SSH登录到华为昇腾GPU服务器后,首先确认NPU设备状态:
# 检查NPU设备列表
npu-smi info

# 检查CANN版本
cat /usr/local/Ascend/ascend-toolkit/latest/version.cfg

# 检查驱动版本
cat /usr/local/Ascend/driver/version.info
预期输出应显示至少一张Ascend 910B设备,状态为OK。如果设备状态显示"Abnormal"或未检测到设备,需要检查PCIe连接或联系平台运维。
# 典型正常输出:
# npu-smi 23.0.0                    Version: 23.0.0
# NPU   Name       Health     Power(W)   Temp(C)    Hugepages-Usage(page)
# Chip 910B       OK         310        68          128 / 8192
第二步:CANN环境变量配置
CANN安装后需要设置一系列环境变量。极智算的昇腾实例已预配置,但如果需要在裸金属上手动配置,以下是标准脚本:
# 添加到 ~/.bashrc 或 ~/.zshrc
export ASCEND_HOME=/usr/local/Ascend
export ASCEND_TOOLKIT_HOME=$ASCEND_HOME/ascend-toolkit/latest
export LD_LIBRARY_PATH=$ASCEND_TOOLKIT_HOME/lib64:$LD_LIBRARY_PATH
export PATH=$ASCEND_TOOLKIT_HOME/bin:$PATH
export PYTHONPATH=$ASCEND_TOOLKIT_HOME/python/site-packages:$PYTHONPATH

# CANN 7.0 新增的环境变量
export ASCEND_OPP_PATH=$ASCEND_TOOLKIT_HOME/opp
export ASCEND_AICPU_PATH=$ASCEND_TOOLKIT_HOME
export TE_PARALLEL_COMPILER=0  # 关闭算子并行编译(调试阶段建议关闭)

# 设置日志级别(调试时改为INFO,生产环境设为ERROR)
export ASCEND_GLOBAL_LOG_LEVEL=3
export ASCEND_SLOG_PRINT_TO_STDOUT=0
执行 source ~/.bashrc 后,用以下命令验证环境:
# 验证CANN工具链
atc --help  # 应显示Ascend Tensor Compiler帮助信息

# 验证Python环境
python3 -c "import ascend; print(ascend.__version__)"npu-smi info 报 "command not found",说明PATH未正确设置。检查 $ASCEND_HOME/toolbox/bin 是否在PATH中。第三步:安装PyTorch昇腾版(torch_npu)
PyTorch的昇腾适配通过 torch_npu 包实现。安装命令:
# 推荐方式:使用昇腾官方whl包
pip install torch==2.1.0
pip install torch-npu==2.1.0

# 或者从昇腾社区镜像安装(国内用户推荐)
pip install torch==2.1.0 torch-npu==2.1.0 \
    -i https://mirrors.huaweicloud.com/repository/pypi/simple
安装后验证:
python3 -c "
import torch
import torch_npu

print(f'PyTorch version: {torch.__version__}')
print(f'torch_npu version: {torch_npu.__version__}')
print(f'NPU available: {torch.npu.is_available()}')
print(f'NPU count: {torch.npu.device_count()}')
print(f'NPU device name: {torch.npu.get_device_name(0)}')
"
预期输出:
PyTorch version: 2.1.0
torch_npu version: 2.1.0
NPU available: True
NPU count: 1
NPU device name: Ascend910B2C
第四步:PyTorch模型代码迁移
从CUDA迁移到NPU的核心代码改动非常有限——大部分情况只需要替换设备指定方式。以下是标准迁移模板:
# === 迁移前 (CUDA) ===
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = MyModel().to(device)
inputs = inputs.to(device)
outputs = model(inputs)
loss = criterion(outputs, labels.to(device))
loss.backward()

# === 迁移后 (NPU) ===
import torch
import torch_npu

# 方式一:自动检测设备
device = torch.device('npu' if torch.npu.is_available()
          else 'cuda' if torch.cuda.is_available()
          else 'cpu')

# 方式二:兼容写法(推荐用于需要同时支持两种设备的代码)
def get_device():
    if torch.npu.is_available():
        return torch.device('npu')
    elif torch.cuda.is_available():
        return torch.device('cuda')
    return torch.device('cpu')

device = get_device()
model = MyModel().to(device)
inputs = inputs.to(device)
outputs = model(inputs)
loss = criterion(outputs, labels.to(device))
loss.backward()
需要特殊处理的算子
不是所有PyTorch算子都有NPU实现。以下是我们在迁移中遇到的需要特殊处理的场景:
| 场景 | 问题 | 解决方案 |
|---|---|---|
| flash-attention (CUDA版) | 依赖CUDA自定义算子,无法直接运行 | 使用昇腾版flash-attention或替换为标准attention |
| xformers | 同样依赖CUDA算子 | 替换为PyTorch原生attention实现 |
| bitsandbytes (8bit量化) | 仅支持CUDA | 使用昇腾的量化工具或切换到FP16 |
| torch.compile() | NPU后端支持不完整 | 使用ATC工具离线编译 |
| 自定义CUDA kernel | 需要重写为Ascend C | 使用Ascend C (类似CUDA的算子开发语言)重写 |
第五步:性能调优参数
迁移完成后,以下参数对昇腾910B的训练性能有显著影响:
# 1. 开启混合精度训练(FP16)
from torch.cuda.amp import autocast, GradScaler
# 昇腾上的混合精度用法与CUDA完全一致
scaler = GradScaler()
with autocast():
    outputs = model(inputs)

# 2. 设置NPU的内存分配策略
# 预分配内存池,减少运行时内存碎片
import torch_npu
torch.npu.set_option({
    "MM_BMM_ND_ENABLE": "enable",  # 开启矩阵乘优化
})

# 3. DataLoader优化
# 昇腾平台建议增加num_workers和prefetch_factor
dataloader = DataLoader(
    dataset,
    batch_size=32,
    num_workers=8,          # 建议设为CPU核心数的1/4
    prefetch_factor=4,       # 每个worker预取4个batch
    pin_memory=False,        # NPU不使用pin_memory
)

# 4. CANN算子调优
# 首次运行时CANN会自动调优算子,耗时较长
# 后续运行会复用调优结果
export ASCEND_LAUNCH_BLOCKING=0  # 生产环境设为0
export TASK_QUEUE_ENABLE=1 # 开启任务队列第六步:多卡分布式训练配置
多卡训练使用HCCL通信库替代NCCL。以DeepSpeed + 数据并行为例:
# DeepSpeed ZeRO-2 配置示例 (ds_config.json)
{
    "train_batch_size": 64,
    "gradient_accumulation_steps": 4,
    "fp16": {
        "enabled": true
    },
    "zero_optimization": {
        "stage": 2,
        "offload_optimizer": {
            "device": "cpu"
        },
        "allgather_partitions": true,
        "allgather_bucket_size": 2e8,
        "reduce_scatter": true,
        "reduce_bucket_size": 2e8
    }
}
# 启动8卡训练命令
# NPU环境使用 hccl_tools 生成 ranktable
python3 -m torch.distributed.launch \
--nproc_per_node=8 \
--master_port=29500 \
train.py \
--deepspeed ds_config.json \
--model_name_or_path meta-llama/Llama-2-7b-hf对于昇腾CANN环境配置中的多卡通信,HCCL的rank table文件生成方式:
# 生成rank table
python3 /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_tools.py \
    --device_num 8

# 生成的 hccl_8p.json 文件会自动写入当前目录
# 设置环境变量指向该文件
export HCCL_CONNECT_TIMEOUT=1800
export HCCL_EXEC_TIMEOUT=1800第七步:模型推理部署
昇腾910B在推理场景中的部署方式有两种:PyTorch直接推理(开发阶段)和ATC离线编译推理(生产阶段)。
PyTorch直接推理
import torch
import torch_npu
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Qwen/Qwen-7B-Chat"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    trust_remote_code=True,
    torch_dtype=torch.float16
).npu()  # 直接移到NPU

# 推理
inputs = tokenizer("你好,请介绍一下你自己", return_tensors="pt")
inputs = {k: v.npu() for k, v in inputs.items()}
outputs = model.generate(**inputs, max_new_tokens=256)
print(tokenizer.decode(outputs[0]))
ATC离线编译推理
生产环境建议使用ATC将模型编译为昇腾OM离线模型,推理性能可提升30%-50%:
# 1. 导出ONNX
python3 export_onnx.py --model_path /path/to/model --output model.onnx

# 2. ATC编译
atc --model=model.onnx \
    --framework=5 \              # 5=ONNX
    --output=model_910B \
    --soc_version=Ascend910B2C \
    --input_shape="input_ids:1,512;attention_mask:1,512" \
    --input_format=ND \
    --precision_mode=allow_fp32_to_fp16
常见问题排查清单
| 问题 | 可能原因 | 解决方法 |
|---|---|---|
| npu-smi 找不到设备 | 驱动未加载或设备故障 | 检查PCIe连接;执行 modprobe drv_ascend |
| torch.npu.is_available() 返回False | torch_npu未正确安装或版本不匹配 | 确认torch和torch_npu版本一致(都是2.1.0) |
| RuntimeError: ACL error | CANN环境变量未设置 | 检查 ASCEND_HOME, LD_LIBRARY_PATH |
| 训练速度远低于预期 | 未开启混合精度或DataLoader瓶颈 | 开启FP16;增加num_workers;检查数据IO |
| OOM (Out of Memory) | 显存不足或内存碎片 | 减小batch_size;使用gradient checkpointing;清理NPU缓存 |
| HCCL通信超时 | 多卡通信配置错误 | 检查rank table;增加HCCL_CONNECT_TIMEOUT |
总结
华为昇腾GPU服务器的部署流程可以归纳为七个步骤:环境检查 → CANN配置 → torch_npu安装 → 代码迁移 → 性能调优 → 多卡配置 → 推理部署。整个流程在极智算预装CANN的昇腾实例上可以压缩到15-30分钟(不包括模型适配时间)。
最大的工作量集中在第四步——代码迁移中处理不兼容的算子和自定义CUDA kernel。建议评估昇腾方案时,先用一天做一个PoC:拉取你的核心模型,按本文流程跑通训练/推理,记录需要修改的代码量和性能差异。PoC的结果是判断迁移可行性的最可靠依据。