
GPU容器还是裸金属服务器?2026算力租赁选型指南_极智算
上周和一个做大模型微调的团队聊天,他们租了8张A100裸金属跑了两个月,结果实际GPU利用率一直在40%上下——大部分时间卡都在等数据加载。这种情况在AI行业太普遍了:花了裸金属的钱,享受了容器的利用率。
反过来也见过另一个极端。有家做自动驾驶仿真的公司,图便宜选了容器化方案跑多卡并行训练,结果NVLink带宽被虚拟化层砍了将近20%,原本3天能跑完的模型硬生生拖到5天。
到底什么时候选GPU容器,什么时候上裸金属?这个问题没有标准答案,但有一套判断逻辑。
容器和裸金属,本质区别在哪里
理解这个问题的关键不在于"容器轻、裸金属重"这种刻板印象。真实差距体现在三个层面:
核心差异:裸金属是物理GPU独占,容器是通过Kubernetes等编排工具将物理GPU切分为逻辑单元。前者追求极致性能,后者追求弹性调度。
从我们实测的数据来看,裸金属在NVLink带宽利用率上能做到95%以上,而容器方案在多租户场景下会有10%-15%的性能波动。这个差距对大模型分布式训练影响非常大——多机多卡场景下,通信带宽损失会直接拖慢整体训练速度。
但容器也有自己的优势。裸金属部署一套训练环境少说要半天,容器方案5分钟就能拉起。做过模型实验的人都知道,快速试错的效率提升远比那点性能损耗值钱。
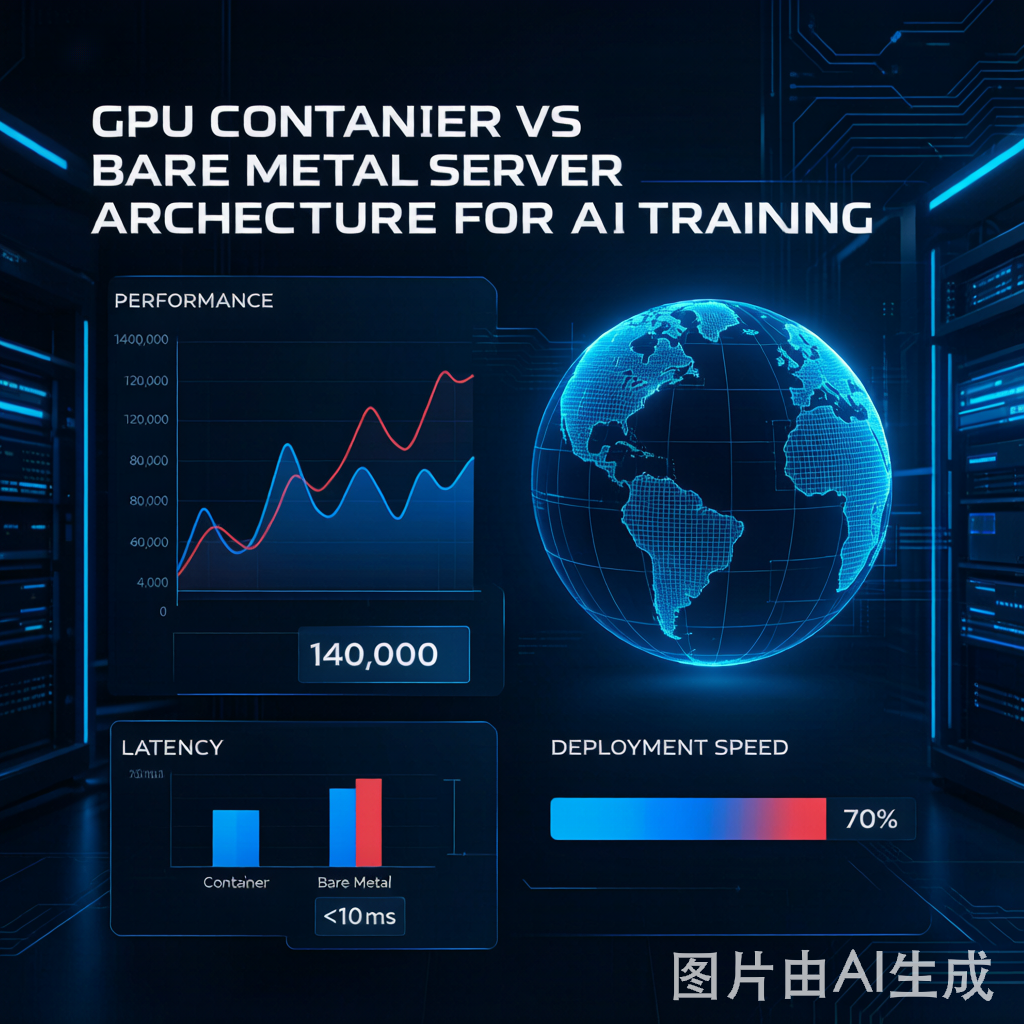
▲ GPU容器化与裸金属部署架构对比示意
四个维度拆开看,你就知道该选谁
1. 性能稳定性
裸金属在这个维度上是碾压级的。某股份制银行AI风控团队的实际案例:把训练任务从容器集群迁移到裸金属后,单轮迭代时间从6天压缩到36小时。原因很简单——金融场景对延迟极度敏感,容器间不可预测的资源争抢直接影响了训练收敛速度。
但要注意,裸金属的性能优势只有在GPU利用率持续超过70%时才真正有意义。如果你的训练任务本身就是间歇性的,大部分时间卡在空转,那性能优势等于白费。
2. 部署灵活性
容器方案在这方面优势明显。以极智算平台的容器服务为例,预集成了PyTorch、TensorFlow、MindSpore等主流框架,选择镜像后直接启动,省去了驱动安装、CUDA配置、依赖冲突这些让人头疼的问题。
做过GPU服务器运维的人都懂:CUDA版本和驱动不匹配、Python依赖地狱、多用户环境隔离——这些事消耗的时间往往比训练本身还多。容器化恰恰把这些问题封装好了。
3. 成本结构
这里有一个很多人忽略的点:算力成本≠GPU租赁费。
| 成本项 | GPU容器 | 裸金属 |
|---|---|---|
| GPU租赁费 | 按小时/分钟计费,灵活 | 通常按月/包周期,单价更低 |
| 运维人力 | 平台托管,几乎为0 | 需要专人维护环境 |
| 闲置成本 | 随用随停,不浪费 | 包月期间闲置照常计费 |
| 环境搭建 | 5分钟内拉起 | 通常需要半天到一天 |
以华为昇腾910B为例,裸金属日租约180-260元/卡,而容器方案按小时计费大约8-12元/小时。单看时薪容器贵,但如果每天只跑6小时,容器反而比裸金属划算40%以上。
4. 适用场景
选容器的典型场景:
- 模型实验和快速验证阶段,需要频繁切换环境
- 多人团队共享算力,需要环境隔离
- 推理服务部署,需要弹性扩缩容
- 短期项目(一周以内),不想为闲置买单
上裸金属的典型场景:
有没有两全其美的办法
有的。目前行业里已经出现"混合部署"的思路:核心训练任务跑在裸金属集群上,推理和实验任务通过容器调度到弹性资源池。既保证了关键任务的性能,又不浪费零散的算力。
举个例子:某AI初创团队的做法是,主力模型训练租用4张昇腾910B裸金属(日均成本约800元),日常实验和A/B测试走容器方案(月均约1500元),总成本控制在1万出头。如果全部用裸金属,月成本要翻一倍不止。
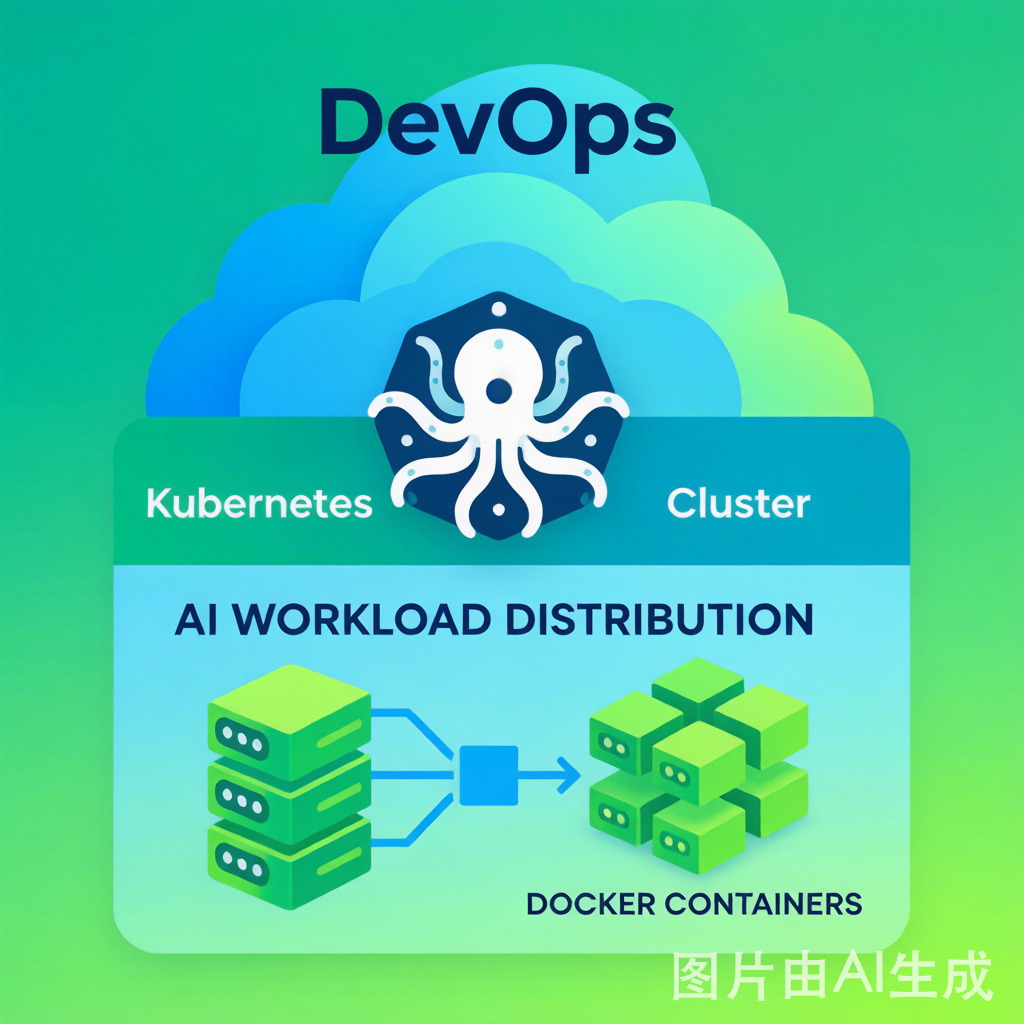
▲ 裸金属+容器混合部署的典型架构
最后说个容易忽略的事
不管选容器还是裸金属,供应商的机房位置和网络质量对训练效率的影响可能比选型本身还大。一个位于核心数据中心的容器实例,性能可能优于偏远机房的裸金属——因为数据传输延迟对分布式训练的拖累远超想象。
选平台时,除了比价格,建议重点看三个指标:节点网络带宽(至少25Gbps)、是否有NVLink/RoCE支持、以及技术支持团队的响应速度。这些"隐性"条件,往往决定了你买到的算力到底能不能用到位。
在容器和裸金属之间纠结?不如先看看实际报价再决定
查看极智算最新GPU报价 →