
自建GPU服务器还是租算力?2026年真实成本对比,看完不再纠结
前段时间和一个做AI创业的朋友聊天,他刚花80万买了4张H100,结果卡还没到货,竞争对手已经用租的算力跑完两轮模型迭代了。
这种事在2026年太常见了。
一、先算一笔账:自建到底要花多少钱?
以8卡NVIDIA A100 80GB配置为例(这是目前AI训练最主流的配置之一),按2026年国内市场行情来算:
硬件采购成本(一次性):
- 8张A100 80GB GPU:约56-64万元(单卡7-8万)
- 服务器主机(含CPU、内存、存储、网络):约15-20万元
- 硬件总计:约75-84万元
机房及基础设施(年化):
- 机柜租赁+电力:约8-12万元/年
- 散热(风冷或液冷):约2-4万元/年
- 带宽费用:约3-5万元/年
- 运维人员成本:约20-30万元/年(至少1-2人)
- 年度运营成本:约33-51万元
三年总成本:
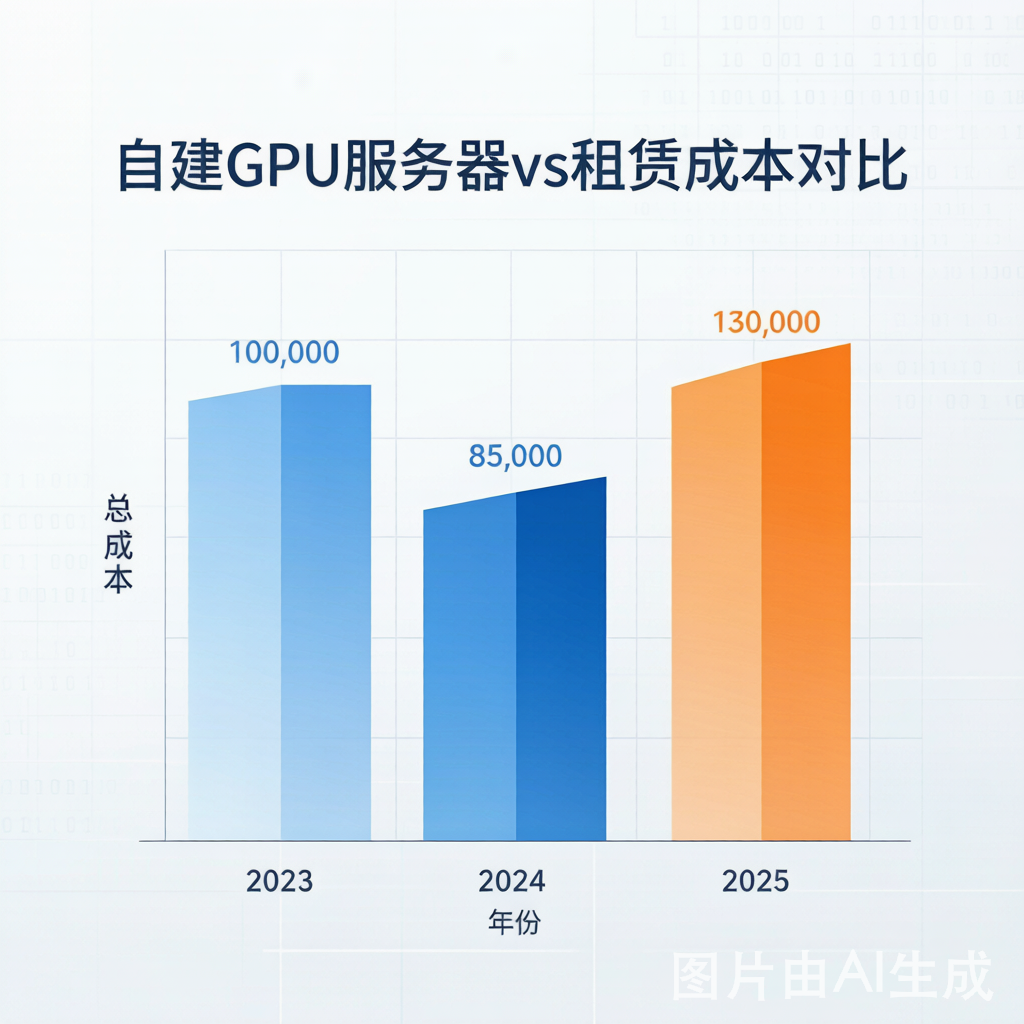
硬件一次性投入约80万 + 运营成本约42万/年 × 3年 ≈ 206万元
加上设备折旧(GPU服务器通常3年折旧),三年后的残值可能只有原价的20%左右。实际持有成本会更高。
二、同样配置,租三年花多少?
8卡A100 80GB的租赁行情:
- 月租约5-7万元(取中间值6万)
- 年租约60-72万元(长期签约通常有折扣)
- 三年总租赁成本:约109万元(按年付折扣计算)
109万 vs 206万。租的成本大约是自建的53%。
这个数字和我在多个来源看到的结论基本吻合。8张A100三年租用成本约为自建的50%左右。
三、除了钱,还有这些隐形差异
交付时间:
- 自建:下单到部署完成,1-6个月(H100等热门型号要排到2027年)
- 租赁:1-3分钟开通,即开即用
这对AI创业公司来说是致命的。6个月时间差,模型迭代可能已经从V1到了V3。
算力弹性:
- 自建:买了8张卡就是8张卡,多了闲置,少了不够用
- 租赁:今天用2张,明天用16张,后天释放——按需伸缩
运维负担:
- 自建:驱动更新、CUDA升级、硬件故障、散热问题……全是你的活
- 租赁:平台负责运维,你只管写代码
技术迭代风险:
- 自建:今年买的H100,明年B300出来了,旧卡贬值加速
- 租赁:随时可以切换到最新型号,不用承担硬件折旧
四、什么情况下自建反而更划算?
也不是所有人都该租。以下几种情况,自建可能更合适:
1. 算力利用率极高(>80%)。如果你的GPU几乎24小时满负荷运转,租的成本优势会缩小。自建的回本周期大概在18-24个月。
2. 数据安全要求极高。金融、医疗、军工等行业的敏感数据,可能不允许上公有云。自建机房是唯一选项。
3. 超大规模(100卡以上)。量大了之后可以和供应商谈折扣,自建的单位成本会显著下降。
4. 有闲置资金和机房资源。如果你本身就有数据中心,新增GPU服务器只是边际成本。
一个简单的判断公式:
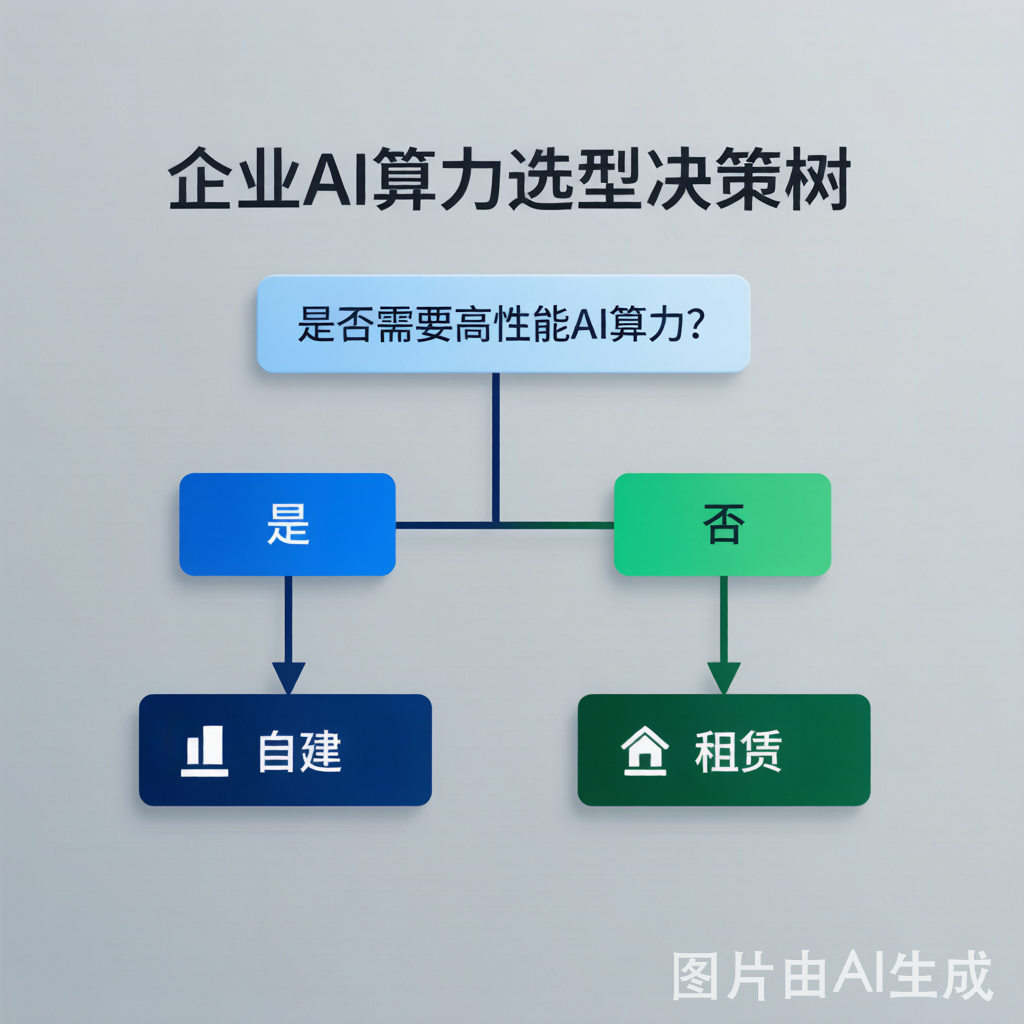
如果预计3年内GPU平均利用率 < 60%,租。
如果利用率 > 80%且有合规需求,买。
中间地带(60%-80%),可以混合部署——核心业务自建,弹性需求租赁。
五、2026年的真实选择:混合部署
我观察到的趋势是:纯自建和纯租赁的企业都在变少,混合部署成为主流。
具体做法:
- 长期稳定的训练任务 → 自建(锁定基础算力)
- 短期实验、峰值负载、新业务验证 → 租赁(弹性补充)
- 推理服务 → 看情况,QPS稳定就自建,波动大就租赁
一个实际的案例:某AI公司自建了32张A100做日常训练,遇到新模型集中训练期就从jygpu.com等平台临时加租16张H100。训练结束就释放。这样既不用为峰值需求多买一倍硬件,也不会在关键时刻卡算力。
最后说一句:2026年选自建还是租赁,本质上不是技术问题,是现金流和业务节奏的问题。如果你账上有几百万闲钱、业务方向稳定、有运维团队——可以考虑自建。如果不是,先租起来跑通业务,等体量大了再考虑买。